Diverse developer blog

株式会社Diverse(ダイバース) 開発者ブログです。

BAR DUNBARの店外サイネージの動画切り替えを launchd + AppleScript で自動化した話

こんにちは。Diverse developer blogです。

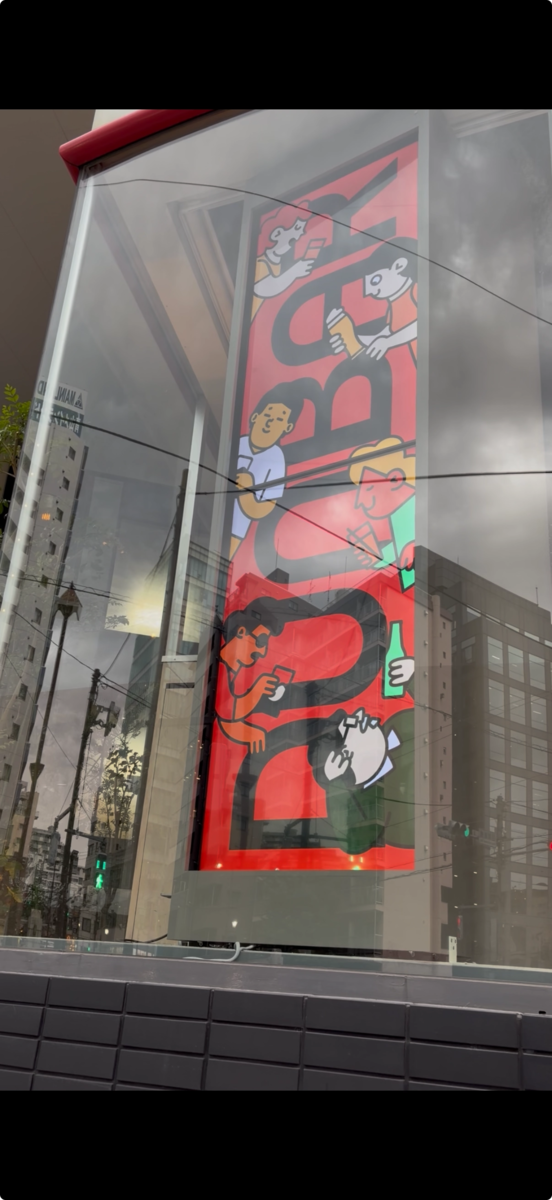
以前、Diverseが運営しているBARの店内サイネージをシステム化した話をしました。前回の店内サイネージの取り組みに続き、今回は店外サイネージの自動化についてご紹介します。

店外サイネージでは、営業中と営業時間外の2種類の動画を流し分けています。今まではこの切り替えを、開店・閉店のたびにスタッフがMacBook(以下Mac)を操作して毎日手動でやっており、忘れると翌朝まで営業中の動画が流れ続けてしまう状態でした。この「毎日決まった時刻にやる手作業」を自動化できないか、というのが今回の取り組みです。

サイネージの出力には元々Macを使っていたので、追加のハードやソフトは何もありません。MacとmacOSの標準機能だけで実現します。

この記事では実装の全体像と、launchd経由の自動実行ならではのハマりどころを紹介します。

今回対応を行ったサイネージ
BAR DUNBARについて

「BAR DUNBAR」はDiverseが運営する、お客様にお酒だけではなく、人とのつながりや共感を提供し “バーコミュニティ”という文化をより楽しんでもらうためのコミュニティバーです。

コミュニティバー「DUNBAR」をオープンしました | 株式会社Diverse

■ Instagram
https://www.instagram.com/bar_dunbar/

■ 食べログ
https://tabelog.com/tokyo/A1316/A131601/13299543/

■ 住所
東京都目黒区下目黒2-20-28 いちご目黒ビル 2F
https://maps.app.goo.gl/ZjAQBnfRsU53Mug4A

目次

毎日の作業は、スワイプ1回だけだった

前回の店内サイネージはアプリとして開発していたため、今回もその延長で店外サイネージ用のアプリを作る方向で考え始めていました。

方針が変わったきっかけは、現地調査と先輩エンジニアの一言でした。実際に店舗での運用を見てみると、営業中・営業時間外の2本の動画をあらかじめフルスクリーンで開いておき、開店・閉店のタイミングでトラックパッドをスワイプして表示を切り替えているだけ。人が操作する場面はそこしかなく、決まった時刻に決まった切り替えが走れば完結します。そこで先輩から「いつもやっている作業の自動実行だけなら、Macの標準機能で足りるのでは?」とアドバイスをもらい、アプリ開発ではなくlaunchdでスクリプトを定期実行する方針に切り替えました。

サイネージの構成

まず前提として、店外サイネージがどういう仕掛けで映っていたかを説明します。

項目 内容
ディスプレイ Hisense「55E6N」55インチ × 2台
設置方法 縦方向に上下2段並べ
映像出力 ビデオウォールコントローラ(4Kマトリックス 2x2)経由
コンテンツ 動画・画像
用途 通行人向けの集客・ブランド訴求

Macの画面に映っているものがそのまま店外に出る構成。つまりコンテンツ管理は『Macで何を全画面表示するか』に還元され、QuickTime Playerでフルスクリーン再生できれば成立します。

要件

  • 毎日 18:00(開店)に営業中の動画へ切り替え
  • 毎日 深夜2:00(閉店)に営業時間外の動画へ切り替え
  • 動画はフルスクリーンでループ再生(Macの画面=サイネージ出力のため、画面全体を動画で占める必要がある)
  • 切り替えは無人で動く(店舗スタッフの操作なし)

全体構成

3層のシンプルな構成です。

① launchd (macOS標準のジョブスケジューラ)
      毎日 18:00 / 2:00 にシェルスクリプトを起動
           ↓
② シェルスクリプト
      QuickTime Player を一度終了 → `open` コマンドで動画を開き直す
           ↓
③ AppleScript
      動画が開くのを待機 → ループ再生ON → フルスクリーン化 → 再生開始

「なぜ3層に分かれているのか」が本記事のポイントです。最初はAppleScript1本で済ませるつもりでしたが、launchd経由の自動実行ならではの罠を踏むたびに役割分担がこの形に収束していきました。詳細は後半の「ハマりどころ」でお話しします。

実装

①launchd — 時刻トリガー

cronのmacOS版にあたるlaunchdにplistを登録します。(~/Library/LaunchAgents/com.user.open-movie.plist)

<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN"
 "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<dict>
    <key>Label</key>
    <string>com.user.open-movie</string>
    <key>ProgramArguments</key>
    <array>
        <string>/bin/bash</string>
        <string>/Users/xxx/scripts/open-movie.sh</string>
    </array>
    <key>StartCalendarInterval</key>
    <dict>
        <key>Hour</key><integer>18</integer>
        <key>Minute</key><integer>0</integer>
    </dict>
</dict>
</plist>

深夜2:00用にもう1枚、Hour を 2 にしたplistを用意します。

②シェルスクリプト — アプリの起動とクリーンアップ

#!/bin/bash
# 前の動画のウィンドウを残さないよう、一度まっさらにする
/usr/bin/osascript -e 'tell application "QuickTime Player" to if it is running then quit'
sleep 2
open -a "QuickTime Player" "$HOME/signage/open-movie.mp4"
/usr/bin/osascript "$HOME/scripts/open-movie.applescript"

ポイントは2つ。

  • 毎回quitしてから開き直す: 差分で切り替えるのではなく毎回クリーンな状態から始めることで、ウィンドウ(タブ)が日々溜まっていく問題を根本から消しています
  • アプリ起動はAppleScriptではなく open コマンド: なぜアプリ起動にAppleScriptを使わないのか、こちらも後述の「ハマりどころ」でお話しします。

③AppleScript — 再生制御

tell application "QuickTime Player"
    -- 動画が開くまで最大30秒待つ(コールド起動対策)
    set waited to 0
    repeat until (exists document "open-movie.mp4") or waited is greater than 30
        delay 1
        set waited to waited + 1
    end repeat
    if not (exists document "open-movie.mp4") then
        error "open-movie.mp4 が30秒待っても開きませんでした"
    end if

    set looping of document "open-movie.mp4" to true
    present document "open-movie.mp4"
    play document "open-movie.mp4"
end tell

present はQuickTime Playerの「プレゼンテーションモード」で、メニューバーもDockも消える真のフルスクリーンです。

🤔 AppleScriptはシェルスクリプトに埋め込めば良いのではないか

その通りで、osascript はヒアドキュメントを受け取れるので、1ファイルにまとめることもできます。 それでも別ファイルにしているのは、AppleScript部分だけを単体実行して切り分けられるようにするためです。 launchd経由の自動実行はエラーの発生箇所を特定しにくく、「アプリ起動(open)の問題か、再生制御(AppleScript)の問題か」を分けて検証できることが、後述のハマりどころの調査でそのまま効きました。 加えて、ヒアドキュメント特有のクォートや変数展開の罠を避けられるという利点もあります。

ハマりどころ

手動実行では動くのに、launchd経由だと動かない——この問題の解決に時間を費やしました。

①AppleScriptの activate でエラー -600

launchd経由のosascriptからは、AppleScriptの activate / launch によるアプリ起動が -600 (アプリケーションは実行されていません) で失敗することがありました。起動リトライを書いても launch 自体が失敗するので粘っても無駄でした。

対策:アプリ起動とファイルオープンはLaunchServices経由の open -a コマンドに全部任せ、AppleScriptは「起動済みアプリの操作」だけに専念させる。3層構成になった最大の理由です。

②アプリのコールド起動だと固定sleepでは間に合わない(-1728)

手動テストのときはQuickTime Playerが起動済みの状態だったため、動画は数秒で開けていました。しかしlaunchd経由の実行ではQuickTime Playerが完全に終了した状態からの起動(コールド起動)になるため、アプリの立ち上げ+動画のオープンに時間がかかります。その結果、動画が開き終わる前にAppleScriptが走ってしまい、-1728 (documentを取り出せません) で失敗しました。

対策:固定sleepをやめ、AppleScript側に「documentが存在するまで最大30秒待つ」リトライループを入れる。無人実行のスクリプトで固定sleepは信用しない、が教訓となりました。

セットアップスクリプトの作成と横展開

問題なく時間通りに自動で動画が切り替わることを確認できたら、別のMacでも動画自動切り替えができるようにするため、作成した「plist 2枚・シェルスクリプト 2本・AppleScript 2本」の計6ファイルを1本のセットアップスクリプトに集約しました。

▶️セットアップスクリプト全文(クリックで展開)

#!/bin/bash
set -euo pipefail

# ===== 設定(環境ごとにここだけ書き換える)=====
OPEN_MOVIE="open-movie.mp4"    # 営業中に流す動画のファイル名
CLOSE_MOVIE="close-movie.mp4"  # 営業時間外に流す動画のファイル名
OPEN_HOUR=18;  OPEN_MINUTE=0   # 開店側の切り替え時刻
CLOSE_HOUR=2;  CLOSE_MINUTE=0  # 閉店側の切り替え時刻
SIGNAGE_DIR="$HOME/signage"    # 動画置き場
# ===============================================

SCRIPT_DIR="$HOME/scripts"
LA_DIR="$HOME/Library/LaunchAgents"
mkdir -p "$SIGNAGE_DIR" "$SCRIPT_DIR" "$LA_DIR"

make_side() {
  local name="$1" movie="$2" hour="$3" minute="$4"

  # --- シェルスクリプト ---
  cat > "$SCRIPT_DIR/$name.sh" <<EOF
#!/bin/bash
/usr/bin/osascript -e 'tell application "QuickTime Player" to if it is running then quit'
sleep 2
open -a "QuickTime Player" "$SIGNAGE_DIR/$movie"
/usr/bin/osascript "$SCRIPT_DIR/$name.applescript"
EOF
  chmod +x "$SCRIPT_DIR/$name.sh"

  # --- AppleScript ---
  cat > "$SCRIPT_DIR/$name.applescript" <<EOF
tell application "QuickTime Player"
    set waited to 0
    repeat until (exists document "$movie") or waited is greater than 30
        delay 1
        set waited to waited + 1
    end repeat
    if not (exists document "$movie") then
        error "$movie が30秒待っても開きませんでした"
    end if

    set looping of document "$movie" to true
    present document "$movie"
    play document "$movie"
end tell
EOF

  # --- launchd plist ---
  cat > "$LA_DIR/com.user.$name.plist" <<EOF
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN"
 "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<dict>
    <key>Label</key>
    <string>com.user.$name</string>
    <key>ProgramArguments</key>
    <array>
        <string>/bin/bash</string>
        <string>$SCRIPT_DIR/$name.sh</string>
    </array>
    <key>StartCalendarInterval</key>
    <dict>
        <key>Hour</key><integer>$hour</integer>
        <key>Minute</key><integer>$minute</integer>
    </dict>
</dict>
</plist>
EOF

  # --- 登録(再実行時は一度unloadしてから) ---
  launchctl unload "$LA_DIR/com.user.$name.plist" 2>/dev/null || true
  launchctl load "$LA_DIR/com.user.$name.plist"
}

make_side "open-movie"  "$OPEN_MOVIE"  "$OPEN_HOUR"  "$OPEN_MINUTE"
make_side "close-movie" "$CLOSE_MOVIE" "$CLOSE_HOUR" "$CLOSE_MINUTE"

echo "=== セットアップ完了 ==="
echo "動画を $SIGNAGE_DIR/ に置いてください: $OPEN_MOVIE, $CLOSE_MOVIE"

パスをすべて $HOME 基準で組み立てているので、別のMacへはこのファイル1個と動画2本を渡して実行するだけで移植できます。時刻や動画名の変更も冒頭を書き換えて再実行するだけ。launchctl への登録・再登録もスクリプト内で行うので、運用者が launchctl コマンドを覚える必要はありません

このスクリプトを使う上でのポイント

  • スリープ・画面ロックが天敵: Macの画面がそのまま店外に出力される構成なので、スリープは「サイネージが消える」、ロック画面は「ロック画面が晒される」ことを意味します。launchdもスリープ中は発火しない(起床後に1回遅延実行される)ため、電源常時接続+スリープしない設定での運用が前提です
  • 初回のみ権限許可が必要: 「osascript → QuickTime Player」のオートメーション許可ダイアログを、セットアップ後の手動テスト時に一度許可しておく必要があります
  • 壁紙は動画のワンショットにしておく: 切り替えの瞬間、QuickTime Playerが終了してから次の動画が全画面になるまでの数秒間、デスクトップがそのまま店外に映ります。壁紙を動画のワンショットにしておけば、切り替え中も見た目が途切れません

最終的なサイネージの挙動

このスクリプトによって、自動で動画が切り替わるようになりました!👏

この動画では7〜11秒あたりで「営業時間外の動画 → 営業中の動画」への切り替えを行なっています。切り替えの一瞬デスクトップが映りますが、壁紙を動画のワンショットにしてあるので違和感なく繋がっています。

まとめ

BARの店外サイネージの動画切り替えを、launchd + AppleScript + QuickTime Player という macOS 標準機能だけで自動化しました。もともとサイネージ出力に使っていたMacに仕組みを足しただけなので、追加のハードもソフトも購入していません。それでも毎日の手動切り替えはゼロになり、「切り替え忘れて営業中の動画が朝まで流れていた」という事故もなくなりました。

作ってみて一番の学びは、手動では動くのに自動実行では動かない、という壁が想像以上に厚いことでした。launchd経由の実行は、手動でターミナルから叩くのと同じようでいて同じではありません。アプリ起動が -600 で失敗したり、コールド起動の遅さで -1728 を踏んだり——同じ壁にぶつかったら、「起動の経路」と「タイミング」を疑うのが近道です。

また、使い捨ての手順書ではなく再実行できるセットアップスクリプトにまとめておいたことで、別のMacへの横展開がファイル1個を渡すだけになりました。無人運用するものは、最初から「作り直せる形」で作っておくのがおすすめです。

もし「決まった時刻に決まった処理を実行したい」という似た課題をお持ちなら、ハードやソフトの購入を検討する前に、いまあるMacの標準機能で足りないか、一度疑ってみてください。案外、plistファイルとスクリプト数本で片付くかもしれません。
社内BIに「そろばん係」を置いた話 — 自然言語でデータを引けるSlack botを作って運用

はじめに

こんにちは、Diverse developer blog です!

社内向けに、Slackでメンションすると自然言語でデータを集計して返してくれるBIアシスタントを作りました。 「そろばんを弾く係」ということで、名前は Soroban としました。

作ってから2ヶ月くらい経ったので、なぜ作ったのか、実際に使ってみてどうだったのか、運用して何が大変だったのかを書いてみます。

なぜ作ったか

前提として、BIそのものが足りなかったわけではありません。

BIツールはありますし、よく見る指標はだいたいダッシュボードになっています。

ただ、実際に仕事をしていると、

「この施策の対象者だけで見るとどうなる?」
「この期間だけだと?」
「この条件を除いたら?」

みたいな質問が結構出てきます。 ダッシュボードにない切り口を見たくなるわけです。

こういうとき、結局SQLを書ける人に聞くことになります。 そうすると依頼が特定の人に集まる。依頼された側も手が空いているとは限らない。結果が出るまで待つことになる。 BIを入れて可視化はかなり進んだのに、データを自由に触れるところまでは行っていないな、という感覚がありました。

このあたりは、NotebookLMを使うことである程度は解決できていました。 社内のデータに関するドキュメントを読ませておけば、それっぽいSQLを作ってくれます。実際、しばらくはそれでやっていました。

ただ、使っているうちに面倒なところが出てきました。

まず、ビッグデータ側のデータを扱おうとすると厳しい。 データウェアハウス側の巨大なテーブルを相手にすると、SQLの方言や社内のルールも違いますし、NotebookLMでSQLを作れても、それをどこで実行するのかという問題もあります。

もう一つは、単純に往復が多いことです。

SQLを生成する
  ↓
コピーする
  ↓
BIツールに貼る
  ↓
実行する
  ↓
エラーになる
  ↓
エラーを持ってNotebookLMに戻る

これを何度か繰り返します。 1回で終わることはあまりなくて、3往復、4往復することもあります。 SQLを書ける人でも普通に面倒です。 ましてSQLを書けない人だと、エラーが出た時点で次に何をすればいいのか分からなくなります。

なので、足りないのはSQLを生成することではなくて、その先だと考えました。

「聞いたら、勝手にSQLを書いて、実行して、結果まで返してくれる人がいたらいいよね」

というのを、そのままSlackに置いてみることにしました。

作ったもの

やっていることは単純です。

Slackでメンションするとエージェントが起動して、

  • データソースの一覧を見る
  • スキーマを見る
  • SQLを実行する
  • 結果をクエリやチャートとして保存する

といったツールを使います。 あとは自分でSQLを書いて、自分で実行して、結果を返す。エラーが出たら自分で直して、もう一度実行します。 さっきのコピペ往復を、BOTの中に閉じ込めただけです。

新しくデータ基盤を用意するのではなく、既存のBIをそのまま実行エンジンとして使いました。 権限やDB接続情報の管理をこれ以上増やしたくなかったのが理由です。既存のBI経由なら、実行されたSQLもそのまま履歴に残るので、後から「その数字どうやって出したの?」となっても追えます。 また、安全弁として、参照系のクエリ以外は実行できないようにしています。

こういうものを大きなプロジェクトとして立ち上げるほどでもなかったので、まずは空いた時間で小さく作ってみました。コーディングAIもかなり使いました。 その結果、最初に動くものがSlack上で動き始めるまでは、それほど時間はかかりませんでした。

使ってみたら、けっこう間違える

AIが間違えること自体は最初から分かっていましたが、実際に運用してみると、どこで間違えるのかが少しずつ具体的になっていきます。 特に問題だったのが、間違っていてもそれらしく回答できてしまうことです。 SQLも回答も形は整っているので、受け取った側からすると合っているように見えてしまいます。

実際にあったのは、こんなケースです。

  • 名前が似ている旧世代のテーブルを引いて、静かに小さい数字を返す
  • 社内の呼び名と実装上の名前がズレていて、似た名前の別機能のデータを混ぜる
  • 存在しないステータス値で絞り込んで、0件をそのまま「0件でした」と報告する
  • データの保持期間の外を集計して、実際より少ない数字を出す

特に怖いのが3つ目です。 聞いた側からすると、「へえ、0件なんだ」で終わってしまいます。エラーなら気づけますが、もっともらしい0件の回答は、間違っていても気づきにくい。

こうしたやり取りを見ていると、最初から分かっていた「ドメイン知識が重要」という話が、具体的な形になっていきました。 どのテーブルを使うべきか、社内ではどう呼んでいるのか、どの値が正しいのか。 これまで人に聞かないと分からなかったことを、少しずつ辞書に追加していくことにしました。

ほぼ辞書を書く仕事だった

どこで間違えるのかが見えてくると、やることはデータ辞書の整備が中心になります。 BOTが参照する正典としてMarkdownを1枚置いて、誤答が出るたびにそこに追記していきました。 最初は100行もないメモでした。今は9倍くらいになって、40節を超えています。2ヶ月ほど運用して、ほとんどこれを育ててきたようなものです。

書き方によって、わりとハッキリ差が出るものがありました。

  • 散文で説明するより、コピペできる例SQLを置く
  • 「〜は必ず間違い」という禁止形で書く

この2つは特に効きました。 「Aを使う」と書くより、「Bは必ず間違い」と書いたほうが守られます。 あとは、「この指標は定義が複数あるので、無修飾で答えずに聞き返す」といった、曖昧さをそのまま扱うルールも入れています。 間違った数字を返されるより、聞き返してもらったほうが助かります。

やっていることは、人間向けのデータカタログを書くのとほぼ同じです。 どのテーブルを見るのか、どの条件を使うのか、社内で使っている言葉が何を指すのか。これまで人の頭の中にしかなかったルールを、少しずつテキストとして残していきました。

守らせたいことは辞書ではなくコードに書く

辞書を厚くしていくと、次は「書いてあるのに従わない」という問題が出てきます。 ここでプロンプトを盛る方向に行くと、検証するたびに全体を書き直すことになって時間が溶けます。実際に一度やってみて、これは違うなとなりました。 そこで、辞書には知識だけを持たせて、絶対に守らせたいルールはコード側に移しました。

エージェントが実行しようとするSQLを検査して、

  • 参照系以外はそもそも実行させない
  • 旧世代のテーブル名や、存在しない値での絞り込みを検知する
  • 巨大なテーブルに期間の絞り込みがなければ止める

といったチェックを挟んでいます。

ここでうまくいったのが、問題を検知しても処理自体は止めず、実行結果に注記を付けてLLM自身に修正させるやり方です。 エラーとして突き返すより、「そのテーブルはこの機能のものですよ」と情報を添えるほうが素直に修正してくれます。 こちらが想定していなかった聞き方をされた場合でも、そこで処理が止まらないのもよかったところです。

フィードバックループは力技で回した

ここは全然きれいな話ではなくて、勝手にフィードバックループが回り始めたわけではありません。 まずは全員に共有して、普通に使ってもらうところから始めました。 その上で、投稿されたやり取りを自分で見に行く。間違った回答があれば拾う。実行されたSQLをログで確認して、知識が足りなければ辞書に足す。挙動の問題ならガードを追加する。 最初のうちは、ほぼこれの繰り返しでした。

しばらく続けていると、使っている側からも「この答えは違うと思う」「こういう聞き方をしたい」と言ってもらえるようになりました。 こちらから見に行かなくても、改善につながるフィードバックが集まるようになっていきます。

誤答を放置すれば、そこで信用されなくなり、使われなくなります。 間違いを拾って修正していけば、次に同じ質問が来たときには正しく答えられる。 そうやって少しずつ使える範囲を広げていきました。

今は利用も広がって、日常的な集計はだいたい問題なく回っています。 聞ける相手が常にいる状態になったことで、数字を確認するためのハードルもかなり下がりました。

これからやりたいこと

辞書とガードの拡充は、これからも続けます。仕様やデータが変われば辞書も更新が必要になるので、ここは終わりがないと思っています。 一方で、運用してみて分かったのは、これを自分一人で見続けるのは難しいということです。

サービスが成長すれば扱うドメインも増えていくので、今のやり方のままではいずれ回らなくなります。 そこで、辞書の更新やガードの追加を、他のエンジニアにも移譲できる形に変え始めています。

その一つとして、コーディングエージェントに辞書更新のためのスキルを追加しています。 新しいフラグやステータスを追加したり、管理画面に新しいラベルを追加したりするときに、その対応関係も辞書に残す仕組みです。

実装している人がその場で知識を残せるようにしておけば、自分が後からコードを追って辞書を更新する必要もありません。 人に「辞書も更新してください」と毎回お願いするより、開発の流れの中に入れてしまったほうが続けやすいと思っています。

そうやってメンテナンスを分散していけば、BOTを一人で抱えなくて済むだけでなく、それぞれのドメインの知識も辞書に残っていきます。 結果として、エンジニア同士でデータや仕様のコンテキストを共有することにもつながるはずです。

最初は自分の仕事を少し楽にするために作ったものですが、運用まで持っていった今は、自分が持たなくても回る状態にしていくことが次のテーマになっています。

おわりに

2ヶ月やってみて一番感じたのは、当たり前ですがデータを民主化するには、ツールを入れるだけでは足りないということでした。 実際に使ってもらうには、社内でしか通じないデータの意味やルールを、ちゃんとコンテキストとして渡す必要があります。 どのテーブルを見るのか、この指標はどう定義するのか、この名前は何を指しているのか。

LLMに間違えられるたびに、これまで暗黙のままになっていたものが少しずつ見えてきました。 結果として、BOTを賢くしていく作業が、そのまま社内のデータに関する知識を整理する作業にもなっています。

「BIツールやAI利用はあるのに、結局エンジニアが聞かれ続けている」という状態の会社は多いと思うので、何かの参考になれば嬉しいです💪

BAR DUNBARのデジタルサイネージをFlutterでシステム化した話

こんにちは。Diverse developer blogです。

今回は、Diverseが運営する「BAR DUNBAR」の店舗内に常設しているデジタルサイネージをシステム化したいという要望に対して普段はアプリやWebなどを主戦場としていたエンジニアがどのようにしてシステムを完成させたのかというお話をさせていただきます。

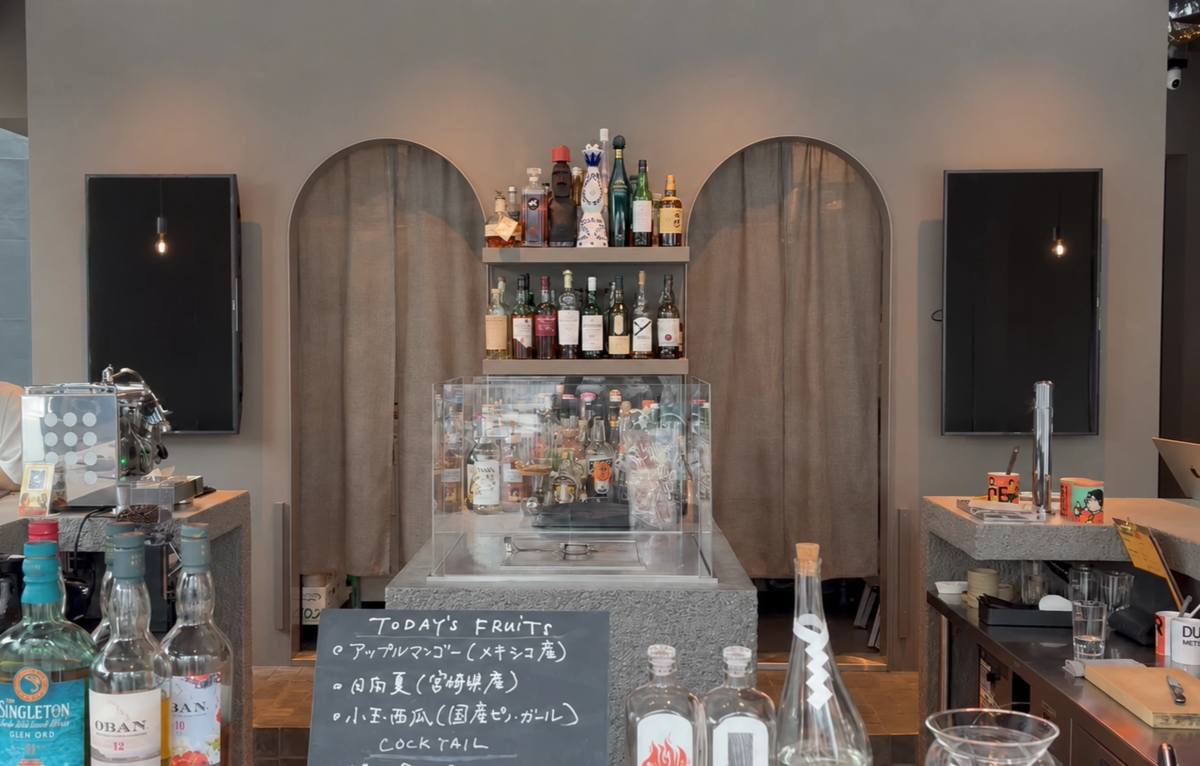
デジタルサイネージシステム完成イメージ

www.youtube.com

本記事を読み進めやすくするために、まずは完成した動画をご覧ください。 2台のディスプレイでは、通常動画が常に同じ再生位置で流れています。 そしてリモコンのボタンを押すと、両画面が同時にお祝い動画へ切り替わります。 この記事では、この仕組みをどう作ったのかを順を追ってお話しします。

BAR DUNBARについて

「BAR DUNBAR」はDiverseが運営する、お客様にお酒だけではなく、人とのつながりや共感を提供し “バーコミュニティ”という文化をより楽しんでもらうためのコミュニティバーです。

コミュニティバー「DUNBAR」をオープンしました | 株式会社Diverse

■ Instagram
https://www.instagram.com/bar_dunbar/

■ 食べログ
https://tabelog.com/tokyo/A1316/A131601/13299543/

■ 住所
東京都目黒区下目黒2-20-28 いちご目黒ビル 2F
https://maps.app.goo.gl/ZjAQBnfRsU53Mug4A

目次

タスクに取り組む前の不安と予測

まず前提としてこのタスクに取り掛かるにあたり、完成までの道筋が全く想像できないというのが率直な感想でした。

デジタルサイネージといえばコンビニなどに常設されている店内動画であるとか、街中にある動画広告のようなイメージしかなく実際にどのような仕組みで運用されているのか理解できていないままタスクに取り組むこととなりました。

今思い出すと複雑に考えていたなと振り返るのですが、当時の私が話を聞いた時点で考えていたのは
管理画面や配信サーバーがあり、それらを介して現地の再生端末を制御するものなのでは?
とイメージしていました。

要件/要望のヒアリング

タスクに取り組むことが決まり、チームメンバーも決まった翌日に早速現地でヒアリングを実施しました。

※その時点でのデジタルサイネージの運用はyoutubeにアップロードした動画を
左右それぞれのディスプレイで自動ループ設定にして流しつづけるという
原始的な運用方法がとられていました。

ヒアリングした結果出た要件/要望は以下の4つでした。

  1. 左右のディスプレイに流れている動画の時間軸を同期させたい(要望)
  2. お客さんの誕生日等の特別なイベント時に、乾杯のタイミングで通常動画から乾杯用の動画へすぐに切り替えたい(必須要件)
  3. 特別な動画に切り替える作業については調理や接客でとても忙しいバーテンダーさんが可能な限り負担なくできるものにしたい(強い要望)
  4. 常時流している通常動画を周年や季節が変わるタイミングで変更したい(要望)

この話を聞いた時点で「イベントが発生したタイミングで手動で動画をすぐに切り替えたい」という要件が入っていたため

  • お祝い動画の再生をシームレスに切り替えられること
  • 容量の大きい動画ファイルへネットワークを介さずにアクセスできること
  • 動画キャッシュ機構の利用しやすさ(そもそもローカルに動画があればキャッシュを気にする必要も無くなる)

といった点を考えると、Webで構築するよりも、動画ファイルをローカルで扱いやすいアプリとして構築した方が相性が良いと考えました。

【今回の対象となるサイネージ用のディスプレイ】

現地調査と開発言語の決定

その前提を踏まえた上で、次に取り組んだのが、サイネージ用のディスプレイに私たちが独自に開発したアプリをインストールすることができるのか?という疑問を解決することです。

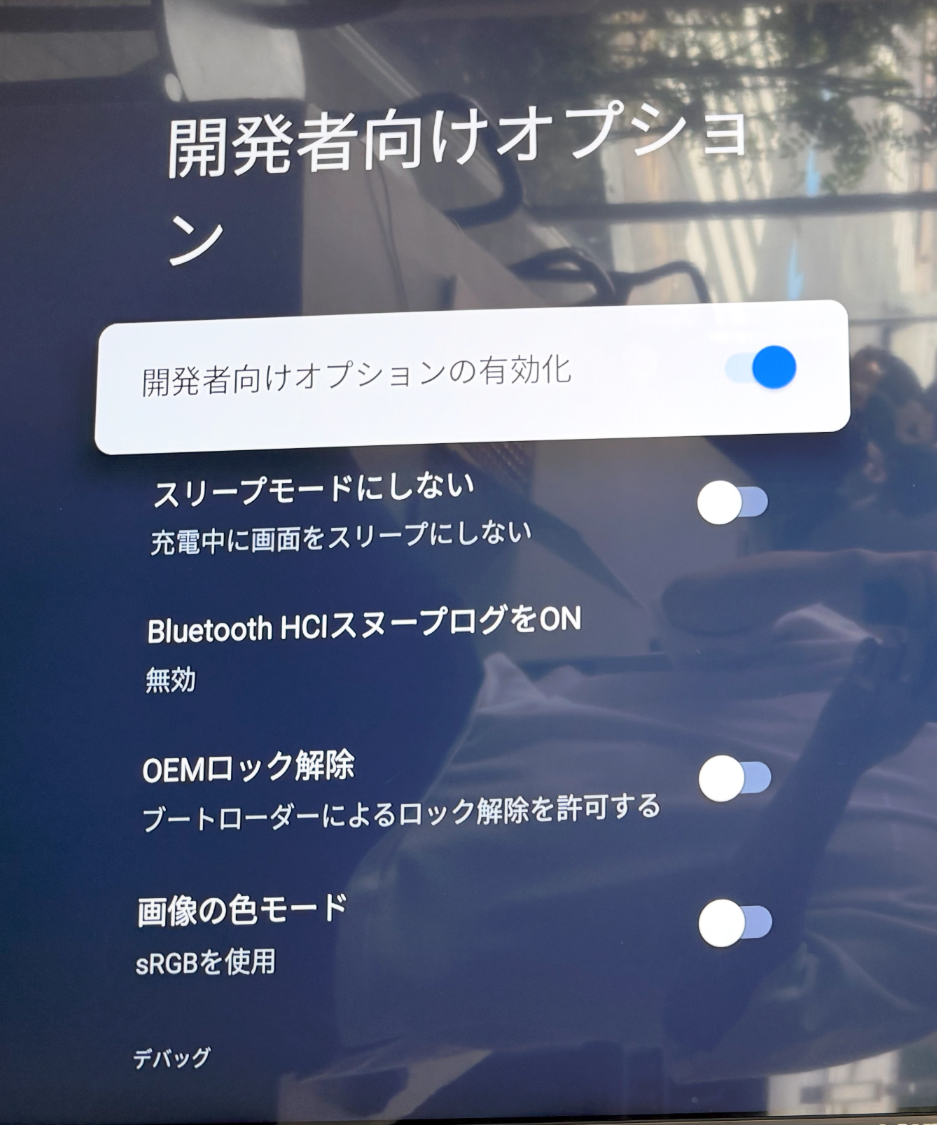
現地調査した結果、幸いにもディスプレイにはAndroid TV OSが搭載されており、Google Play Storeも存在していました。さらに開発者オプションも有効にすることができたため、ADB経由でサンプルアプリをインストールできることを確認できました。

【店舗に設置されているディスプレイのスペック】

- モデル: Sony BRAVIA Professional Display
- 画面サイズ: 43インチ / 4K
- OS: Android TV 11
- 映像処理チップ: Realtek RTD シリーズ (H.264 ハードウェアデコーダ内蔵)
- GPU: ARM Mali
- 設置台数: 2台
- 設置向き: 物理的に90°反時計回り回転で壁掛け

【開発者向けオプションの有効化】

実際にアプリのインストールが可能であると判断できたため、次に決めるべきことはアプリを開発するための言語をどうするのか?ということです。

結論からいうとDiverseで開発実績もあるFlutterを採用することにしました。 今回はAndroidアプリの開発ということで単一コードでマルチプラットフォームで動かせるというFlutterの核となるメリット自体は活かせないですが、社内にはFlutterに精通したメンバーが多数いるのと、知見も豊富なため、今後のメンテナンスも考慮し、Flutterを採用しました。

動画の再生機能から着手

まずはローカルにてAndroid EmulatorとAndroidの実機を用いて開発に着手しました。

動画の再生には video_player パッケージを利用しています。ただし一つ制約があり、店内に置かれているサイネージ用ディスプレイは物理的に90°反時計回りに設置されているため、動画をそのまま再生すると異なる向きで再生されてしまいます。

開発当初は動画の再生widgetをRotatedBox(quarterTurns: 1)で制御しようと考えていました。しかし動画レイヤーにはNative SurfaceViewを使う必要があるにもかかわらず、Flutter widgetの回転はNative SurfaceViewには伝播しないという制約があります。

そこで試行錯誤した結果、widgetの回転ではなく動画自体をFFmpegで90度時計回り(CW)に回転してlandscapeとして保存するという原始的な手法を採用することになりました。

動画再生の落とし穴(1)

ローカルでの動画の再生については一切問題なかったのですが、現地に赴き試してみると画面が真っ黒になりいつまで経っても動画が再生されないという現象が起こりました。

通常のアプリであればVideoPlayerControllerのinitialize()が失敗すれば何かしらのエラーメッセージがLogcatに出るはずです。しかしLogcatには何も出ず、デバッグの手掛かりが何も掴めないという不測の事態となってしまいました。

そこから数時間試行錯誤した結果、私達は一つの仮説に辿りつきました。

「Realtekハードウェアデコーダは高ビットレートのH.264ストリームと相性が悪いのではないか?」

というものです。

ためしにFFmpegで動画のビットレートを5Mbps程度に落としたところ仮説は見事に当たり動画が再生されることを確認できました。

「Realtek」とは半導体チップを作っている台湾の会社のことであり
ディスプレイで使用しているチップ(Realtek RTD シリーズ)には
映像デコーダや音声処理、HDMI入力処理、CPU, GPUなどが全部詰まっています。
本記事では便宜上、このディスプレイに搭載されているRealtek製SoC/デコーダ周辺の挙動を
まとめて「Realtek」と呼んでいます。

動画再生の落とし穴(2)

しかし動画は再生できるものの、Logcatには「MediaCodec.setOutputSurface: IllegalArgumentException」というエラーメッセージが永遠に出続け、安定して動画が再生されない現象が再現されました。

調査した結果Flutterが内部でtextureの再バインドを試みる際、Realtekデコーダが setOutputSurface() を拒否するためということが分かりました。 これを解決する策は video_player のVideoViewType.platformViewを使うことでした。

VideoPlayerController.file(
  file,
  viewType: VideoViewType.platformView,
)

これでネイティブSurfaceViewに直接描画する形式になり、texture viewの再バインドは走らなくなりました。

動画再生の落とし穴(3)

まだまだ落とし穴はありました。Flutterの新レンダラーであるImpellerを有効にした状態でBRAVIAのMali GPU+Platform Viewを扱うと、動画の再生処理中に黒画面になってしまうことも分かりました。こちらはImpellerを無効にすることで、従来のレンダラーである Skia/GLES にフォールバックさせることで解決する事ができました。

<meta-data
    android:name="io.flutter.embedding.android.EnableImpeller"
    android:value="false" />

以上の3点の問題を解決することで、無事、サイネージ用のディスプレイで通常のループ動画を安定して流すことができるようになりました。

※ローカルでは上手くいっていることを現地で実際に試してみると、予期せぬトラブルが往々にして発生することを身をもって学ぶことができました。

複数ディスプレイでの動画の再生位置の同期の手法

複数のディスプレイで再生されている動画の再生位置を同じにしたいという要望を実現するために2つのアプローチを検討しました。

(1) 中央サーバー方式

1つ目は動画の再生を制御する中央サーバーを用意し、ディスプレイをスレーブとすることで、一元管理する手法です。

                 [店内 LAN]
                     │
        ┌────────────┴────────────┐
        │                         │
   [管理サーバー]              [BRAVIA #1]
   (Raspberry Pi 等)          (Flutter アプリ)
        │                         ↑
        │                         │ WebSocket
        ├─────────────────────────┤
        │                         │
        ↓                         ↓
   [BRAVIA #2]               [BRAVIA #N]
   (Flutter アプリ)          (Flutter アプリ)

こちらの方式を採用すれば再生位置の同期だけではなく、再生する動画の種類を選択できることや、動画の切り替えなども管理画面を通していつでも制御できるという強力なメリットがあります。

しかし、サーバーの用意や別途管理画面を用意したり、アプリ側にもWebSocketによるイベントの制御を行う必要があり、今の規模を考えると少し大袈裟なシステムであると感じたため、このアプローチは見送ることになりました。

(2) NTP-based 分散方式

2つ目は各ディスプレイが独立してNTPに現在時刻を問い合わせ、共通の時計を基準として再生位置を決定する方式です。

                     ntp.nict.jp
                          |
              (各機が独立に問い合わせ)
                          |
        +-----------------+-----------------+
        |                 |                 |
        v                 v                 v
    BRAVIA #1         BRAVIA #2         BRAVIA #N
 ntp offsetを保持  ntp offsetを保持   ntp offsetを保持
   (Flutter app)     (Flutter app)     (Flutter app)
        |                 |                 |
        +-----------------+-----------------+

こちらの方式が優れている点は外部依存がNTPサーバーだけになるので、構成が比較的シンプルになることです。ディスプレイの管理台数が2台と少ないため、店舗運用のシンプルさを優先し、NTP方式を採用することになりました。

動画の再生位置は (NTP現在時刻 mod 動画長) で決定します。

同期時刻の調整

NTP同期は構成としてはシンプルですが、実用上ほぼ同期しているように見せるには、いくつかの調整が必要でした。

(1) 外れ値の除去

まず NTP から返される時刻は、起動のタイミングによっては外れ値が混じることがあったので、アプリの起動時に ntp.nict.jp を 5 回叩き、その中央値をオフセットとすることで外れ値を除去する調整を入れました。

(2) 累積ドリフトの調整

また通常動画をループしていると微妙に端末時計に差分が発生し、累積的に位置ずれが発生するため30分ごとにNTPを再同期する調整もいれました。

*ドリフトとは、各端末の時計や再生位置が
時間経過とともに少しずつずれていく現象を指します。

(3) ドリフト調整の3段階補正

それでも微妙にずれることがあったので15秒ごとに「期待位置」と「実際位置」を比較し、差分に応じて補正する対応も入れました。

  • < 50ms: in sync (何もしない)
  • 50〜1000ms: ソフト補正 → setPlaybackSpeed(1.0 ± up to 2%) で緩やかに補正
  • ≥ 1000ms: ハード補正 → 即 seek + speed を 1.0 にリセット

ソフト補正で速度を数%変えても、視聴者にはほぼ気付かれないくらいの調整となります。ハード補正を行うと動画が一瞬だけ飛んだように見えますが動画をじっと注視していない限りは意外と気付かれない程度のものとなります。

(4) ループ境界での再同期

動画が末尾に到達して先頭に戻る瞬間に端末ごとに数ms〜数百msのズレが発生し、それが累積する現象もありました。これを検出するために、「再生位置が末尾5秒より後 → 先頭5秒より前」というジャンプを検知したら、その瞬間にNTP位置に再seekするロジックも入れています。

計測結果

経過時間 expected actual diff 状態
00:00:00 — — — Initial sync: seek to 148,230ms (of 352,233ms)
00:00:15 163,241 163,229 +12 ms in sync
00:02:30 298,241 298,219 +22 ms in sync
00:05:00 95,775 95,793 −18 ms in sync
00:07:30 245,775 245,750 +25 ms in sync
00:10:00 43,309 43,317 −8 ms in sync
00:12:30 193,309 193,322 −13 ms in sync
00:15:15 338,309 338,243 +66 ms speed=1.0044 (soft)
00:17:30 128,843 128,830 +13 ms in sync
00:20:00 278,843 278,857 −14 ms in sync
00:22:30 76,377 76,349 +28 ms in sync
00:25:00 226,377 226,371 +6 ms in sync
00:27:30 24,411 24,390 +21 ms in sync
00:30:00 174,411 174,415 −4 ms in sync
【実測精度】
これらの調整を入れた状態で30分連続稼働させて計測すると位置ずれの平均数値は19〜48msとなり
一般的な体感として違和感が出にくい目安である100ms未満に抑える事ができました。

お祝い動画の切り替えイベントの検知

デジタルサイネージシステムの必須要件として通常動画からお祝い動画へ切り替えられるというものがあり、かつ「調理や接客でとても忙しいバーテンダーが、IT操作を意識せずに、限りなく少ない負担で操作できるようにしたい」という要望もありました。

その話を聞いたときに複数のアイデアが思い浮かびました。

  • 調理場にある管理用のiPadに動画切り替え用のショートカット/アプリ/Webページを作成してタップしてもらう
    • 🔺画面切り替え、タップやスワイプ操作が発生し、思っているよりかは簡単ではなさそう
  • バーテンダーさんが身につけているSmartwatch用のアプリを作成して、そのアプリをタップしてもらう
    • 🔺Smartwatch用のアプリ開発/運用コストが発生、Smartwatchを瞬時に操作するのは意外に難しい、普段使いのSmartwatchを使うため機種の限定が難しい
  • AmazonDashのような専用の物理ボタン機器を購入し、ボタンを押してもらう
    • ❌外部機器購入コストの発生、専用ボタンの追加開発が必要、物理デバイスに依存するので気軽に試すことができない。

どの手法も、可能性としてはありだが、簡単に試すことができず、またバーテンダーさんの負担を限りなく抑えるという要望に応えるには不十分であり、もっとも頭を悩ませたところです。

テレビのリモコンは使えないのか? - 正解は意外と身近に存在する

イベントの検知手法について頭を悩ませていたところ、突然アイデアが舞い降りてきました。

「例えばテレビを見ているときに、地震が発生して、リモコンでニュース番組に切り替えるくらいの感覚で操作できればよいのではないか?」

リモコンが使えるという発想は元々なかったのですが、Android TV OSであること、チームメンバーと話している中でbluetoothを使えばいいのでは?というような話がでていたこと、操作の容易性を考えると結局は物理ボタンがいいと考えていた事、これらの思考が有機的につながり、最終的には最も身近にあったリモコンを使うという発想に至ることができました。リモコンが使えるのであれば外部機器の追加購入も不要であり、イベントの送信部分に関しても追加で実装する必要はなくなります。

さっそく実装の調査を開始したところHardwareKeyboard.instance.addHandlerを利用することにより最下層のレイヤーで全てのキーをキャッチできることが分かりました。さらにリモコンのいいところはチャンネル切り替えのための数字も使え、色ボタンもキャッチすることができるので、押すボタンによってお祝い動画の内容も変えるということの実現も容易になったということです。

お祝い動画の切り替えイベントの他機種への伝播手法

次に一方をお祝い動画に切り替えたらもう一方が連動して切り替わる仕組みの検討をすることにしました。もちろん原始的には一方をリモコンで切り替えて、続けてもう一方をリモコンで切り替えるという手法を取ることはできます。しかし調理や接客で忙しいバーテンダーさんが物理的に切り替える作業が必要なため、どれだけ早く操作しても1秒〜3秒のずれはどうしても発生してしまうこととなります。結果的に特別なイベントの演出の一体感を損なうことにも繋がりかねないため、できるだけ同時のタイミングで切り替えられる方式を模索することとなりました。

(1) WebSocket方式

まず検討したのはFirebase Realtime Database等の外部WebSocketサービスを利用し、各ディスプレイがイベントを常時subscribeする方式です。

【WebSocket方式】

 [リモコン (数字キー押下)]
              |
              v
          BRAVIA #A
    +--------------------------+
    | HardwareKeyboard が捕捉  |
    | -> Firebase RTDB に write|
    | -> ローカルでも event    |
    |    動画を発火 (同期)     |
    +------------+-------------+
                 |
                 | HTTPS / WebSocket
                 | write: /events/current = {
                 |   "event_id": "cheers",
                 |   "triggered_at": <ts>
                 | }
                 v
    ============= [インターネット] =============
                 |
                 v
        +-----------------------+
        | Firebase Realtime DB  |
        |   (Google Cloud)      |
        +-----------+-----------+
                    |
                    | subscribe 中の全機に push
                    | (WebSocket)
                    v
    ============= [インターネット] =============
                 |               |
                 v               v
            BRAVIA #B        BRAVIA #C
        +----------------+ +----------------+
        | onValue 発火   | | onValue 発火   |
        |    ↓           | |    ↓           |
        | event 動画発火 | | event 動画発火 |
        +----------------+ +----------------+

                    結果: 全機が同期して event 動画に切替
         (インターネット往復ぶんのレイテンシ: 50〜500 ms)

この構成は現実的ではありましたが、以下の懸念点がありました。

  • プロダクトの規模に対して外部サービスを経由させる必要性が薄い
  • インターネットを往復させるため50-500ms程度のレイテンシがどうしても発生してしまう
  • 一方のアプリでリモコンイベントの受信後、イベントの書き込み処理 → もう一方がその書き込みを検知する仕組みが必要となり、想定よりも実装が複雑になる

これらの理由により、WebSocketによる実装は一旦断念することとなりました。

(2) UDPブロードキャスト方式

次に検討したのはUDPブロードキャストを利用するという方式です。

UDPブロードキャストは、同じLAN上のすべての機器に、一斉に同じデータを送る仕組みとなります。送信側は個別の宛先を知らなくても、"ブロードキャストアドレス" (255.255.255.255 など) 宛に送ることで、そのネットワーク上の全機に届かせることができます。任天堂Switchのローカル通信であったり、ネットワーク機器がLANに繋がったときに「DHCPサーバーいませんか?」というような信号をブロードキャストで叩いているなど、身近な機器でも利用されている一般的な技術となります。

構成としては以下のようになります。

【UDPブロードキャスト方式】

    [リモコン (数字キー押下)]
              |
              v
          BRAVIA #A
    +--------------------------+
    | HardwareKeyboard が捕捉   |
    | -> UDP broadcast 送信     |
    | -> ローカルでも event      |
    |    動画を発火 (同期)       |
    +------------+-------------+
                 |
                 | UDP send
                 | 宛先: 255.255.255.255 : 5556
                 | payload: "event:xxxxxx"
                 v
    ================ [店内 LAN] ================
                 |               |
                 v               v
            BRAVIA #B        BRAVIA #C
        +---------------+ +---------------+
        | listen socket | | listen socket |
        |    ↓          | |    ↓          |
        | event 動画発火 | | event 動画発火  |
        +---------------+ +---------------+
        
           結果: 全機が同時に event 動画に切替
          (LAN 内なのでレイテンシは 数 ms 以下)

デジタルサイネージシステムにおいてUDPブロードキャスト方式が優れている点は

  • 追加機器の購入/外部サービスが不要であり、気軽に試すことができる
  • レイテンシは同じLAN内で通信することにより数ms以下に抑えることができる
  • 実装も比較的シンプル

というものがあります。ただしTCPとは異なり、到達保証や順序保証がないというデメリットもありますが、今回の用途においては許容できると判断したためUDPブロードキャスト方式を採用することになりました。

アプリサイズの肥大化に対応する

当初からの方針として、再生する動画はアプリの中にバンドルした上で参照することにしていました。ただし実際にバンドルしてみると通常動画が300MBもあったり、それに加えてお祝い動画も追加すると合計で500MBの巨大なアプリとなってしまいました。これでは開発 → deployというサイクルを回すたびに10分の待ち時間が発生してしまうこととなります。

肥大化に対応するために、動画自体はディスプレイ本体の内部ストレージにコピーした上でアプリはそのコピーを参照するという方式に変更したところ最終的には40MB程度に抑えることができました。

権限の落とし穴

「動画を端末ストレージに置く」だけなら簡単そうですが、Android 11以降のscoped storage制約が落とし穴でした。

adb shell mkdir -p xxx

で作成したディレクトリはshellユーザーの所有となります。この状態でファイルを配置するとアプリ側から

PathAccessException: Directory listing failed
(OS Error: Permission denied, errno = 13)

というエラーがでて読めませんでした。ディレクトリがshellユーザーの所有であるために権限がないということですね。

解決策としては動画を配置する前にアプリ側でディレクトリをapp所有で作った後に、adb pushで動画を配置するという方式をとることで解決できました。

インストールスクリプトの開発

これらの手順を踏みながらアプリのインストール作業を行うことは煩雑となるため

  1. adb/ ffprobe 等のツールのインストールチェック
  2. 実際に転送する動画がassets/videos以下に存在するのかをチェック
  3. ffprobeによってコーデック/解像度/ビットレートを自動でバリデーションする
  4. APKをビルド/インストールする
  5. インストールしたアプリを一瞬起動し、アプリの所有権限でディレクトリを作成する
  6. 動画をadb pushする

これら一連の作業を自動で行なってくれるツールを作成することにより、難しいことを考えなくとも一気通貫でインストール作業を完了できるようにしました。

通常動画素材の切り替え方式

要望の一つとして通常動画も季節やイベントによって切り替えたいというものがありました。

こちらはディスプレイ側に動画をあらかじめコピーしておき、アプリ側で月・日・時と動画ファイルのマッピング定義をアプリ側に持たせ、再生する動画をそのマッピング定義により決定するというロジックで実装しています。

class LoopScheduleEntry {
  final int month, day, hour;
  final String filename, label;
}

const List<LoopScheduleEntry> kLoopSchedule = [
  LoopScheduleEntry(month: 1,  day: 1,  hour: 0, filename: kDefaultLoopFilename,     label: 'default'),
  LoopScheduleEntry(month: 7,  day: 7,  hour: 0, filename: kAnniversaryLoopFilename, label: 'anniversary'),
  LoopScheduleEntry(month: 7,  day: 13, hour: 2, filename: kDefaultLoopFilename,     label: 'default'),
];

これにより、あらかじめ配置済みの動画の範囲であれば、周年や季節に応じた切り替えを自動化できるようになりました。

今後の課題

ただし、通常動画も固定するのではなく、更新したいという要望も追加で発生しているため、どうすれば簡単に更新作業が行えるのかという点についてはこれからの課題として残っています。

タスクに取り組むことで得られた学び

(1) シミュレーションでは完璧だったことが現場ではうまくいかないことが往々にしてある

本文でも触れていますが、ローカルで開発し、様々な検証を行い、準備万端の状態で店舗へ赴き、予測では数分で終わるだろうと思っていたことが、動画の再生が思うようにいかなかったり、予期せぬエラーに見舞われたりと実際には順風満帆に進行することはありませんでした。

準備は万全だったとしても、現場ではエラーが発生するという心構えをもって臨むということが大切だと学びました。

(2) 課題を解決する方法は意外とシンプル

タスクに取り組む前は、複数の外部サービスの利用や外部機器の追加購入をし、ネットワークを介して複雑なシステムを開発するようなものをイメージしていました。

しかし最終的に完成した設計は外部サービスを使わず、外部機器の追加購入も不要であり、外部ネットワークの利用も最低限なシンプルな設計にすることができました。

複雑に考えていたことが、一つ一つの要素を分解すると最終的には意外とシンプルな設計に落ち着くこともあることを学びました。

(3) AIは強力だが全てを解決しない。もっとも重要な部分は人間の発想が決め手になることもある

本プロジェクトはAIと相談しながら進行し、また実装についてもAIの力を借りています。比較的つまずくこともなく進行できたこと、また未知の技術に取り組めたことはAIの力によるところが大きいです。

ただし、AIは基本的には人間が入力した情報や質問によってアウトプットが左右される一面があり、人間が現場での状況や情報を全てAIに与えるのは実質的には不可能であり、それによってアイデアの元になる情報が欠けてしまうことがあります。

それに対して人間は現場での情報を自然に把握していたり、あえて言語化していない情報も無数に持っています。

リモコンを最終的なイベント送信デバイスとして利用できないか?という件はAIとの壁打ちをしている中では一切登場しないまま発想したものなので、人間の観察や発想の中から生まれてきたものだと考えています。(その発想に至ってからはイベント送信デバイスとしてのリモコンについてAIと壁打ちし、実装までをスムーズに進行することができました。ありがとうございます😊)。

最後に

普段開発しているサービスでは実装した機能が実際にユーザーにどのように使われているのか?とか、どのように喜ばれているのかということを生の反応として知るのが構造的に難しいという一面があります。

デジタルサイネージシステムは実店舗で運用され、お客さんの反応も即座に得られ、開発者と利用者の距離が近いので普段の開発とはまた違った開発体験を得ることができました。

今後もバーという実店舗と様々な技術を組み合わせることで店舗に訪れてくれたお客さんの満足度を高めるような施策に取り組んでいきたいと考えています。

NotebookLMでYYCの仕様を質問できるようにした

こんにちは、Diverse developer blogです。

はじめに

プロダクトの仕様について、エンジニアなら誰しも一度は「これってどういう仕様でしたっけ?」と質問された経験があると思います。

プロダクトを運営していると、仕様の全てを把握するのは難しく、仕様確認の依頼はエンジニアのところに集まってきます。その都度コードを読みに行くことになり、こうしたコストは地味に積み重なっていきます。

今回はそのやり取りを、NotebookLMに肩代わりしてもらう仕組みを整えました。

これまでの仕様確認フロー

これまでYYCでは仕様調査の一部を Devin に任せてきました。コードベースを一定理解しているAIに質問ができる、というのは非常に便利です。

エンジニア以外のメンバーが自分で仕様を確認できる手段ができたことで、エンジニアへの問い合わせが減り、運用としても定着していました。

運用見直しのきっかけ

しかしDevinの料金体系が変更され、これまで無料で気軽に使えていた範囲が有料化されました。

cognition.ai

そのまま課金して使い続ける選択肢もありましたが、仕様確認の用途であればコストを抑える方法があるはず。

そう考え、代わりになるツールを検討した結果、NotebookLMを採用することにしました。

なぜ NotebookLMを選んだのか

判断の軸になったのは、次の4つの観点です。

1. 料金

Devin で行っていた仕様調査と同じことが、NotebookLM なら追加コストなしでできる。

2. Google Workspace との統合

弊社ではGoogle Workspace を使っているため、社員のアカウントとアクセス管理がそのまま利用できる。

3. Devinの良いところを継承している

具体的には次の2点

  • 引用付きの回答:答えの根拠(どのファイルのどの部分を参照したか)が明示されるので、AI の答えを鵜呑みにせず裏取りできる

  • 参照範囲の限定:NotebookLMにアップロードしたソース以外は参照しないので、ハルシネーションが起こりにくい

4. Google エコシステムの将来的な恩恵

NotebookLM と Workspace は Google が継続的に改善している領域で、便利に改善してくれる流れにも乗れる。例えば、今手動で行なっているNotebookLMのソースの更新も、将来的に自動化できる可能性があり、新しいツールや契約を増やさずに、できることが広がっていくという期待ができる。

これらを踏まえ、引き続きコストがかからず・安全に・コードベースで仕様確認ができるという点が決定打でした。

NotebookLMにソースコードを渡したいが、膨大なコードは「そのまま」では渡せない

NotebookLMにはソース1ファイルあたり約 50 万語という上限があります。

support.google.com

一方、YYCは長年培ってきた大量のコードを抱えており、様々なコードが入り混じっています。とても1ファイルに収まる規模ではありません。

NotebookLMのソースとしてプロダクトのコードをアップロードするには、「単にコードを集めるツール」ではなく「何を含めて何を含めないかを決める、適切な単位に分けて渡せるツール」が必要でした。

Repomixを使ってNotebookLM向けにコードを分割する

この問題を解決するために、Repomix を使って NotebookLM 向けのコードパックを生成しつつ、その分割方法を設計しました。

github.com

Repomix とは、リポジトリのファイル群を1つのテキストファイルに集約してくれるCLI です。includeやignore のglob指定、出力フォーマット選択(plain / xml / markdown)、コメント圧縮といった「LLM向けにコンテキストを渡す」前提の機能が揃っています。

まずは「どのコードを含めて、どの単位でファイルに分けるか」を整理することから始めました。実際の思考フローは、次のような順で進みました。

  1. 容量制限

    → ソース1ファイルあたり約50万語という上限を超えないようにする

  2. 不要コードの除外

    → 仕様確認に使わないコード(テストコードなど)は含めない

  3. 残すコードの判断軸

    →「仕様やSQLの質問に答えられる」を満たす範囲で取捨選択

  4. サーバーとクライアント両方の参照

    → 画面の情報を参照しつつ、裏側のサーバーの仕様も答えられる構成にしたいが、両方を1ファイルにまとめると上限を超えてしまう

  5. 分割方針の決定

    → サーバーは論理レイヤーで複数ファイルに切り分け、クライアントは1ファイルに収める

この結果、サーバー側5ファイル + クライアント側1ファイルとして書き出し、それらをすべて同じノートブックにまとめてアップロードする構成に落ち着きました。


設計はこれで決まったので、あとは実行できる形にまとめるだけです。

弊社ではMakefile にターゲットを作成し、ファイルを書き出す運用にしました。

以下は実際に Makefile に追加した内容です(一部抜粋)。

REPOMIX_OPTS := --style plain --compress
REPOMIX := npm run --silent repomix --
REPOMIX_DATE := $(shell date +%Y%m%d)

repomix: 
    @echo "==> server/Data層 (+本番スキーマ)"
    @$(REPOMIX) $(REPOMIX_OPTS) --output repomix-server-data-$(REPOMIX_DATE).txt \
        --include "Data層ファイル, スキーマ" \
        --ignore "***/**/*"
    @echo "==> server/Model層"
    @$(REPOMIX) $(REPOMIX_OPTS) --output repomix-server-model-$(REPOMIX_DATE).txt \
        --include "Model層ファイル" \
        --ignore "***/**/*"
    @echo "==> server/Handler+Site層"
    @$(REPOMIX) $(REPOMIX_OPTS) --output repomix-server-handler-$(REPOMIX_DATE).txt \
        --include "Handler+Site層ファイル" \
        --ignore "***/**/*"
    # ... 管理画面系、その他、クライアントと続く

分割の単位は以下の6つ

ファイル 含まれるもの
repomix-server-data-{date}.txt Data 層のソースコード + DB スキーマ
repomix-server-model-{date}.txt Model 層のソースコード
repomix-server-handler-{date}.txt Controller 層(リクエスト処理層)
repomix-backend-admin-{date}.txt 管理画面系のコード(複数の管理プロダクトを一括)
repomix-backend-misc-{date}.txt 上記以外のバックエンドコード(共通ユーティリティ等)
repomix-client-{date}.txt クライアント
💡 --compress と --style オプションについて

--compress
コード圧縮を有効にします。本質的な構造要素を抽出・保持しながら、実装の詳細を除外することで、LLM処理のためのトークン数を削減することができます。

--style
出力形式を指定できます。今回はNotebookLMが読みやすいplainで出力するようにしました。

実際の使い方

あとは make repomix で生成された6ファイルを NotebookLM のノートブックにドラッグ&ドロップでアップロードするだけです。

「メッセージを1通送るのに、ポイントはいくつ必要?」「足あとがつくのはどのタイミング?」「特定のユーザーのプロフィールを取得するSQLを教えて!」などの質問にコードを根拠にした回答が返ってきます。

まとめ

今回の取り組みで、Devinに頼っていた『コードベースの仕様確認』を追加コストなしで継続できるようになりました。

ポイントは、NotebookLM のソース容量制限という壁を Repomix で突破できたことです。「何を含めて、どう分けるか」さえ一度設計してしまえば、あとは出力してアップロードという作業だけで、いつでも最新の状態に更新できます

また、Google Workspace 上で完結するため、アクセス管理も既存の仕組みをそのまま使えます。新しいツール契約や情シスとの調整なしに移行できたのも、大きなメリットでした。

NotebookLM 側ではソース自動同期に向けたアップデートも進められており、手動で行なっているソースファイルの生成も、いずれ不要になりそうな見込みです。

workspaceupdates.googleblog.com

こうしたエコシステム側の進化に合わせて、開発フローの中で自然に使い続けられる仕組みにしていきたいと思っています。

Diverseのジュニアエンジニア採用の魅力 ~ エンジニアをどう育てているか ~

こんにちは。Diverse developer blogです。今回は、Diverseで実施しているジュニアエンジニア採用について、どのような採用枠なのか、入社後にどう育成しているのかをご紹介します。

ジュニアエンジニア採用とは

ジュニアエンジニア採用は『業務でのエンジニア経験が未経験〜5年以内の方を対象にした採用枠』です。エンジニアとして今後成長できるポテンシャルのある方を、長期目線で育てていくことを前提にしています。

Diverseの自社マッチングサービス『YYC』は、累計登録ユーザー数が1,900万人を超えるプロダクトで、20年以上の開発・運営の実績があります。SNS、マッチング、ライブ配信の機能を持つこのプロダクトの開発チームに、サーバーサイドを主軸としながら他の領域にも挑戦していく、という育成方針でジュニアエンジニアは配属されます。

育成プログラムのステップ

入社から9ヶ月以降まで、段階的に目標を設定しています。後述するとおりDiverseに入社するすべてのエンジニアに共通するもので、記載している期間は目安です。

入社オンボーディング

働く上で必要なツールのセットアップと、Notionに自己紹介ページの作成をしてもらいます。最初の数日で、社内のコミュニケーションに参加できる状態を作ります。

試用期間中(0〜3ヶ月)

この期間は、社員とプロダクトの理解を最優先にしています。具体的には以下のような内容です。

  • 週次1on1
  • スクラムへの参加
  • プロダクトを実際に使う
  • 開発環境の構築
  • 簡単なスプリントタスクにトライ

いきなり大きなタスクを任せるのではなく、まずは「何を作っているチームなのか」「どんなユーザーが使っているのか」を知ってもらう期間として設計しています。

試用期間後(3〜9ヶ月)

プロダクトの仕様、事業目標とチーム目標の理解を深めてもらいます。社員のサポートを受けながら、スプリントタスクを自分で完了できるようになることを目指します。

9ヶ月以降

事業目標とチーム目標に関わる成果を出すフェーズに入ります。同時に、次のグレードへのスキルアップを目指してもらいます。

育成プログラムは研修か

カジュアル面談でよく聞かれる質問があります。「この育成プログラムは研修ですか?」という質問です。質問の背景には、早く現場に入って実務で自分を伸ばしていきたい、業務から離れた研修は避けたい、という気持ちがあるのだと思います。

先にお答えすると、この育成プログラムはすべて実務です。業務から切り離した研修プログラムではありません。週次1on1もスクラムへの参加もプロダクトを使うことも、Diverseのエンジニアが日常的にやっていることで、それに最初から加わってもらいます。

もう一つ重要な点があります。この育成プログラムはジュニアエンジニアのためだけに作ったものではなく、Diverseに入社するすべてのエンジニアに共通で受けてもらう内容です。

経験の浅い方は9ヶ月ほどかけて各ステップを進みますが、豊富な経験を持っている方であれば同じステップを1週間で終えることもあります。記載している「0〜3ヶ月」「3〜9ヶ月」「9ヶ月以降」はあくまで目安で、できる人は早く終わって次に進めますし、時間がかかる人はそれなりにかかる、というだけの話です。

なぜ経験を問わず、同じ育成プログラム(オンボーディングとも社内では呼んでいます)を受けてもらうのかというと、どれだけ業務経験があってもプロダクトの仕様や事業の特性、チームの雰囲気は入社してから理解する必要があるからです。プロダクトを実際に使う、スクラムに参加する、といった内容は経験豊富な方にとっても価値があり、むしろそういう方ほど早く吸収して次のステップに進んでいきます。

Diverseは1スプリント1週間のスクラムで開発しており、年間約48回のリリースサイクルを回しています(詳細は2023年の振り返り記事を参照)。この短いサイクルの中で、自分のペースで進んでいける設計になっています。

developer.diverse-inc.com

チーム開発の特徴

Diverseでは、Engineer・Designer・Biz・CS・QAメンバーが1つのチームとなり、スクラムで開発を進めています。

チームでは「なぜこの機能を作るのか」「どうすればユーザーに価値が届くのか」を議論します。ジュニアエンジニアとして入社した方も、このチーム議論に最初から参加します。実装だけを切り出して任せるのではなく、上流の議論にも触れてもらうことで、「何を作るべきか」を考える習慣を早い段階でつけてもらうためです。

開発環境

ジュニアエンジニアとして入社した方が触れる開発環境は以下のとおりです。

  • インフラ:AWS(ECS, Aurora MySQL8 など)
  • 構成管理:Terraform
  • 分析基盤:Looker / Re:dash
  • 監視:Mackerel / Sentry
  • CI/CD:GitHub Actions / CircleCI
  • その他:GitHub / Slack / Asana / Notion / Miro
  • 開発手法:スクラム開発
  • 言語やフレームワーク:Perl / Python(Lambda) / TypeScript(Vue) / Dart(Flutter)

サーバーサイドの言語にはPerlを利用しています。20年以上運営しているサービスですが、現在のYYCのバックエンドは最新のPerl5.40とDebian Bookwormで稼働しています。2024年にPerl5.8とCentOSから最新のLTSバージョンまでアップデートするプロジェクトを完了させています(詳細はこちらの記事)。

developer.diverse-inc.com

長年運営されているサービスと聞くとレガシー環境を想像される方も多いかもしれませんが、言語もOSも最新のLTSバージョンで稼働しており、新規で作るものはユースケースに応じてPythonやTypeScriptなども採用しています。

AIツールも、エンジニアはClaudeCodeやCodexを会社の経費で利用可能です。ジュニアエンジニアもAI使って開発することは可能です。

ジュニアエンジニア採用の実績

ジュニアエンジニア採用は2年半ほど前に募集を開始し、これまでに1名を採用しました。入社から2年が経過した現在、サーバーサイドエンジニアとして活躍しています。

今後、ジュニアエンジニアとして入社する方は、この先輩社員をメンターにしながら一緒に働くことができます。同じ立場でスタートした社員が身近にいる環境は、「どうやって成長していけばいいのか」の具体的なイメージが湧きやすく、質問もしやすいはずです。育成ステップを実際に経験してきた人だからこそ伝えられる話があります。

メンターになる社員の経験談

ここからは、当社のジュニアエンジニアとしてどのような環境で働き、どのように成長していけるのかを、実体験をもとにお伝えします。


未経験の私がエンジニアとして活躍できるようになるまで

私は未経験からエンジニアとしてDiverseに入社し、現在3年目になります。以前はエンジニアとは全く異なる業界で働いていました。未経験からの転職では、「どんな環境でスタートするのか」が大きな不安になると思います。そこで、先ほどご紹介した「育成プログラム」の各ステップを、私が実際にどのように歩んできたのか。弊社でのリアルな成長のプロセスをお伝えできれば嬉しいです。

【STEP 1】試用期間中(0〜3ヶ月): 「ハテナ」だらけのスタートから、チーム開発の基礎へ

入社直後の私は、独学で少し触れていたもののターミナルのコマンド入力すらおぼつかない状態でした。環境構築や、文字を一行修正するだけのタスクでも時間がかかり、エンジニアとしてやっていけるか不安に感じていました。それでも、定期的な1on1やプロダクト理解のための説明会など、手厚いフォローがあったおかげで、まずは「何を学ぶべきか」を整理することができました。

入社2ヶ月目からは、管理画面のデザイン一新と改修を担当することになりました。実はこの時、エンジニアとしてこの改修をメインで担当したのは未経験の私一人でした。

「未経験の私に務まるかな?」と不安もありましたが、弊社には『Fail Fast, Go Higher — 大胆に試そう、成長しよう』という行動指針が根付いています。この価値観によって、気負いすぎず「まずはやってみよう」と前向きに取り組むことができました。

もちろん丸投げではありません。わからないことがあれば常に質問できる環境ではありますし、私が大胆に試せるようにしっかりサポートしてくださる安心感がありました。

一通りの実装を一人でやり切る責任感を早い段階で味わえたのは、この価値観を大事にする会社ならではの経験だったと思います。

【STEP 2】試用期間後(3〜9ヶ月): 膨大なコードに圧倒されながらも、ペアプロで一歩ずつステップアップ

入社半年が過ぎる頃には、実際のプロダクトに関わるタスクや、クライアントとのAPI連携なども任せてもらえるようになりました。

歴史のあるプロダクトゆえにコード量も膨大で、構造の理解に苦しむことも多かったです。そんな時は迷わず、先輩エンジニアに「ペアプログラミング」を依頼してタスクを進めることもありました。先輩エンジニアの実装の進め方を隣で見ることで、一人で悩んで進めるよりも何倍も速く成長できたと感じています。

また、自分一人では理解が難しい技術的なところでぶつかった時も、相談すると快く勉強会を開催してもらったりしました。個人の技術力ももちろん大事ですが、それ以上に「チームとしてどう成果を出すか」を弊社では大切にしているので、周りの知識をどんどん吸収して成長していくことを、みんながポジティブに応援してくれました。

【STEP 3】9ヶ月以降〜現在: 3年目の今、実感するエンジニアとしての面白さ

現在はマッチング機能だけでなく、ライブ配信機能などプロダクト内の多岐にわたる機能開発に携わっています。

弊社のプロダクトは非常に多機能なので、一つのサービスにいながら様々なアーキテクチャに触れられるのが、エンジニアとして大きな魅力です。

また、リリースした施策の結果を数値で共有してもらえる場もあり、自分の実装がどれくらいユーザーに届き、プロダクトを動かしているのかをダイレクトに知ることができます。

入社したての頃は「一行の修正」に必死でしたが、今では「プロダクトの成長を左右する機能」を任せてもらえるようになりました。自分のできることが増えていくにつれて、ユーザーやプロダクトに与えられる価値が日に日に大きくなっているのを実感できること。 それが今の私にとって、一番のやりがいです。

最後に、これから入社する皆さんへ

最初はわからないことだらけで当たり前です。私もそうでした。 弊社は、未経験でも早い段階から実際のタスクを任せてもらえ、自分の手でリリースまで一貫して経験できる環境です。複雑な仕様に頭を抱えることもありますが、それを乗り越えるたびに確実にレベルアップできます。

次は私が、皆さんが「大胆に試せる」ように全力でバックアップし、同じチームのエンジニアとして一緒に切磋琢磨し、高め合えるような関係を築いていきたいと思っています。皆さんと一緒に働ける日を楽しみにしています!

まとめ:ジュニアエンジニア採用で大事にしていること

育成にはそれなりにコストがかかります。先輩エンジニアが時間を割いて質問に答える、1on1を毎週やる、インプット期間中は大きな成果を求めない、といった投資が必要です。

このコストを払ってもジュニアエンジニアを採用している理由は、考え方の合う人材を中長期で育てていきたいからです。過去にジュニアエンジニアとして入社して成長したメンバーの実績もあり、先輩エンジニアは自分から聞きに行けば、基本的な質問でも答えてくれる文化があります。

また、Diverseには継続的な改善を怠らない姿勢があります。機能開発と並行しながらPerlとDebianのアップデートプロジェクトをやり切った実績からもわかるように、目の前の開発だけでなく、中長期でプロダクトと開発環境を良くしていくことを重視しています。ジュニアエンジニアとして入社した方にも、こうした改善の取り組みへ段階的に関わってもらいたいです。

逆に言うと、ジュニアエンジニアとして入社する方には『自分で開発したり、自分から聞きに行く姿勢』を期待しています。わからないことを放置せず、素直に質問できる方と一緒に働きたいと考えています。

最後に、ジュニアエンジニア採用は『未経験〜5年以内のエンジニアを、9ヶ月以降に成果を出せる状態まで育てていく採用枠』です。累計登録ユーザー数1,900万人・運営20年以上のプロダクトでスクラム開発に最初から関わりながら段階的にスキルアップしていくことができます。

ブログの内容やDiverseに興味のある方は、ぜひ以下の採用ページからカジュアル面談へ。様々なご意見をお待ちしています。

diverse-inc.co.jp

Figma MCP vs Pencilを実務で比較してみた話

こんにちは、Diverse Developer Blog です。

はじめに

YYCのフロントエンド開発では、Figmaデザインを基にしたUI実装が不可欠ですが、この工程には依然として多くの手作業が残っています。

近年、AIを使ってこの工程を効率化するアプローチが増えてきており、「どこまで実装を自動化できるのか?」が気になっていました。

そこで今回は、

  • Figma MCP
  • Pencil

の2つを対象に比較検証しました。

本記事では、「実装工数の削減」と「デザイン再現性」の観点から見えた、比較検証の結果を共有します。

ツールの特徴

まずは、比較する2つのツールの立ち位置を整理します。

Figma MCP

Figma公式が公開しているMCPサーバーを介し、LLM(Claude等)が直接Figma API経由でデザイン情報を取得する仕組みです。

  • 公式リポジトリ: https://github.com/GLips/Figma-Context-MCP
  • AIがFigmaデザインを読み取り、コード化するための参照用として設計
  • get_file(ファイル取得)、get_nodes(要素取得)、get_image(画像取得)など、デザイン情報取得に特化
  • 実行環境:クラウドベース

👉 既存のデザインをAIに参照させるための仕組み

Pencil (Pencil.dev)

Pencilは、AIエージェントとの連携を前提に設計されたデザインツールです。

  • 公式サイト: https://www.pencil.dev/
  • "Built for AI agents": AIによる操作を前提に設計
  • "Canvas as a Database": キャンバスが単なる画像ではなく、AIが編集可能なJSON構造データとして扱う
  • "Bidirectional editing": AIと人間が双方向に編集可能
  • 実行環境:ローカルファースト(.penファイル)、Gitで管理可能

👉 AIがデザインを読み取りつつ、直接編集・再構築できる環境

特徴まとめ(2026年4月現在)

観点 Figma MCP Pencil
役割 デザイン情報の参照 デザインの編集・再構築
AIとの関係 読み取り+書き込み 読み取り+書き込み
データの扱い API経由で取得 JSON構造データ(直接操作可能)
管理方法 クラウド ローカルファイル、Git
コスト Figmaプランに依存 無料

検証方法

実際のプロダクト開発で使用するFigmaデザインを対象に、以下の2パターンで検証しました。

パターンA:Figma MCP

  • Figmaデザインをそのまま使用
  • Claude Code(Opus 4.6)からMCP経由で参照し、コード生成

パターンB:Pencil

  • FigmaデザインをPencilに移行(ほぼコピペで再現可能)
  • Claude Code(Opus 4.6)からMCP経由でPencilデータを参照し、コード生成

対象

  • Webブラウザ(Vue3、SCSS)
  • モバイルアプリ(Flutter)

※ 同一UI・同一要件で比較

検証結果

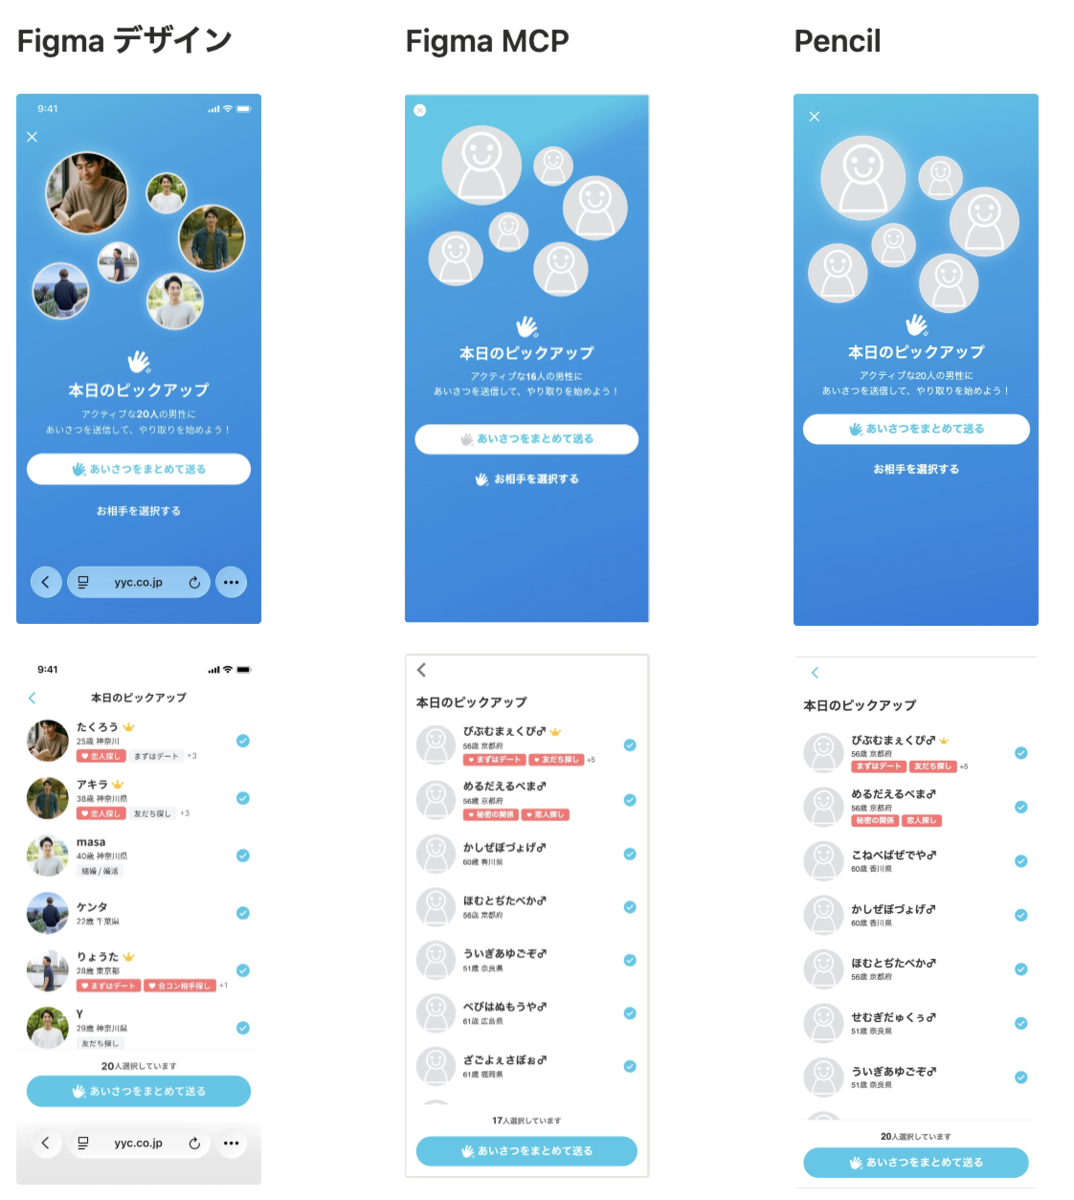
Webブラウザ(Vue3、SCSS)

  • 両者ともに、UI構造はほぼ再現
  • 一覧画面のヘッダー・フッター固定なども、プロンプト指定なしで実装
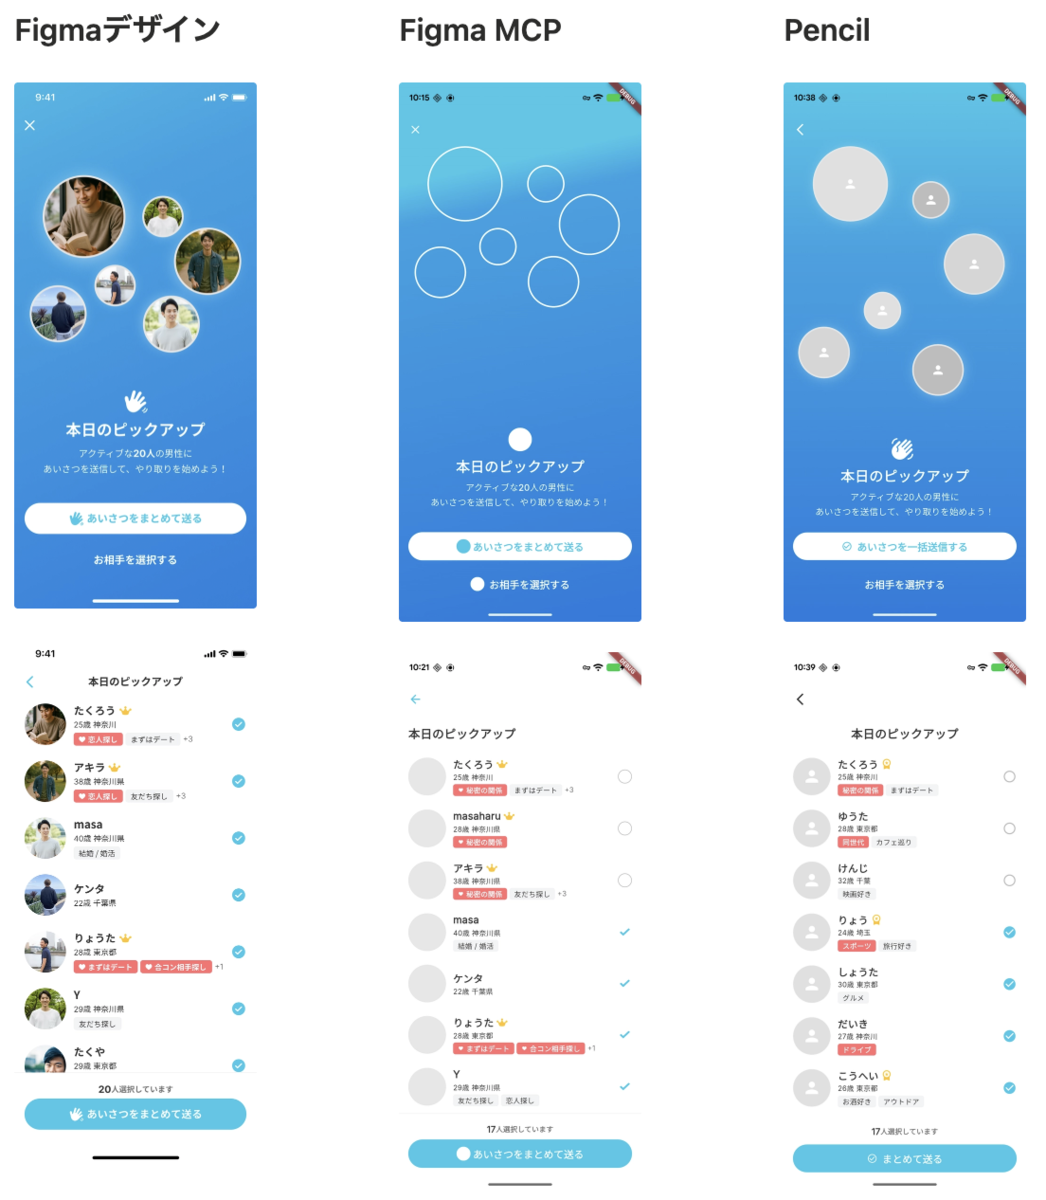
  • 全体的にPencilの方がデザイン再現度は高い傾向
    • グラデーション
    • ボーダー有無
    • 余白やサイズなど細かいスタイル

一方で、以下の点は両者共通の課題として見られました。

  • アイコン画像の選定が不安定(生成ごとにブレる)
  • カラー変数・スタイル定数の参照が不安定

モバイルアプリ(Flutter)

  • 両者ともに、UI構造はほぼ再現
  • ベースのFigmaデザインのコンポーネント階層も再現した実装
  • Figma MCPの方がデザイン忠実度が高い結果に

また、Webと同様に以下の傾向が見られました。

  • アイコン画像の選定が生成ごとにブレる
  • カラー変数・スタイル定数の参照が安定しない

初回生成後の修正フロー

スタイルやアセット参照の課題については、プロンプトの工夫やskillsの整備により、おおよそ8割程度の完成度までは安定して出力可能になりました。

その後、主に以下の修正を行っています。

  • コンポーネント構成の最適化 (Figmaデザインと実装の設計差分や、エンジニアごとの粒度差による調整)
  • スタイルの微調整
  • ビジネスロジック(JS/Dart)など動的処理の実装

まとめ

再現性について

再現性は以下の3軸で評価しました。

  • UI構造(レイアウト・階層)
  • スタイル(色・余白・装飾)
  • アセット参照(画像・アイコン・変数)

その結果、

  • UI構造:両者とも高精度
  • スタイル:
    • Web → Pencilが優位
    • モバイル → Figma MCPが安定
    • リスト型のようなシンプルなUIでは差は小さい
  • アセット参照:両者とも不安定

現時点では「構造の自動生成」には極めて強いものの、「詳細なスタイリング」と「プロジェクト固有のアセット参照」には、人間によるコンテキストの補完(プロンプトでの補足や、skillsの整備、デザインシステム側での命名規則の徹底)が不可欠です。

実装工数削減について

今回の検証では、実際にプロダクトへ組み込む前提で評価しました。

  • どちらも生成コードをそのまま使うのは難しい
  • 特に以下の修正が必要になるケースが多い
    • アイコン差し替え
    • カラー変数の置き換え
    • コンポーネント分割・整理

一方で、UIの骨組みはほぼ完成しているため、ゼロから実装するよりは確実に工数削減になりました。

体感としては、

  • 50~80%程度の工数削減効果は見込める
  • “完全自動化”にはまだ届かない

という位置付けでした。

評価項目 Figma MCP Pencil 備考
UI構造の再現 ◎ ◎ 両者ともに精度が高い
スタイル再現(Webブラウザ) ⚪︎ ◎ PencilのJSON構造がCSSと相性良
スタイル再現(モバイルアプリ) ◎ ⚪︎ Figmaの階層構造がFlutterと親和性高
アセット参照 △ △ アイコン画像やスタイル変数の紐付けに課題
導入の容易さ ◎ ⚪︎ Pencilは移行コストが発生
工数削減(体感値) 50~
80%
50~
80%
下書き生成ツールとして極めて優秀

最後に

アウトプットの品質自体に大きな差はありませんでしたが、ワークフローの観点では差が見られました。

  • Pencilはエディタ上でデザインを開きながら、AIと対話し修正できる
  • デザインをコードと同様にバージョン管理できる

これらを踏まえると、Pencilが無料である現時点では、品質・スピード・ワークフローに置いてメリットが大きいと感じました。

一方で、デザインデータの扱いについては運用設計が重要になります。 当社としても、将来的にPencilをマスターデータとして扱うことは現実的な選択肢の一つだと考えていますが、現時点では段階的な移行が前提になると認識しています。

特に、デザインレビューの進め方やデザイナー・エンジニア間の役割分担といった既存のプロセスを変えずにツールのみを移行すると、データの二重管理や認識の不一致が発生しやすくなります。

そのため当社では、まずはFigmaをデザインの正としつつ、Pencilを実装領域で活用する二層構造の運用を採用し、今後は新規開発領域から段階的にPencil中心のワークフローへ移行していく方針が現実的だと考えています。

出会いの「温度感」をマッチング検索に乗せるために Two-Tower Model と Solr KNN でやったこと

こんにちは、Diverse Developer Blog です。

今回は、YYC のマッチング検索に、SageMaker 上で学習した Two-Tower Model のユーザー Embedding を使ったベクトル検索 (Solr KNN) を追加した話をします。

チャンスタイムやデイリーミッションといった既存のルールベースの行動導線は引き続き動かしつつ、「自分と温度感が近い相手」を ML ベースの検索で並行して返せるようにする、という構成です。

TL;DR

  • これまで YYC のマッチング機会は、チャンスタイム(新規登録直後)やデイリーミッション(継続期)といったルールベースの行動導線で設計していました
  • ただ、ユーザーの目的が多様化するにつれて「全員一律の導線」では受け止めきれない部分が出てきたため、温度感 という軸を決定論的に定義し、それを教師情報として 64 次元のユーザー Embedding を学習する仕組みを追加しました
  • 学習は Amazon SageMaker 上の Two-Tower Model で行い、推論結果は Solr の Dense Vector フィールドに投入、KNN 検索で「温度感の近い相手」を返せるようにしています
  • 既存のルールベース導線とは置き換えではなく併用で、検索結果の一部を ML 側から差し込む形で運用しています

1. これまでの設計

YYC には、ユーザーのライフサイクルに応じた行動導線がいくつかあります。

  • チャンスタイム(新規登録直後): チュートリアル完了時に時間制限で、一定時間のあいだプロフィール閲覧やメッセージ送信が無料になる施策です。初動のアクションを後押しして、最初の 1 通までの距離を縮める役割を担っています。
  • デイリーミッション(継続期): 一定の条件で抽出された相手に対してあいさつ(初回メッセージ)が無料で送れる仕組みで、日々の行動を後押しして継続利用につなげる役割を担っています。
  • 検索ロジックのルールベースの並び替え :「新規ユーザー優先」「最終ログインが近い順」など、経験則ベースの並び替えです。

いずれも「誰にどの動線を踏ませるか」をルール側で先に決め打つ設計で、登録直後はチャンスタイム、その後はデイリーミッションという役割分担になっていました。

ルールベースの強み

先に書いておくと、ルールベースの設計自体に問題があるわけではありません。数年単位で YYC を支えてきた土台で、以下のような強みがあります。

  • 説明可能性が高い: 「なぜこの動線が出たか」をコードと config で完全に説明できます。運営や CS からの問い合わせにもすぐ答えられます。
  • 即効性がある: 新しい施策を思いついてから数日で本番に出せます。
  • 数値設計が容易: 送信上限や有効時間などのパラメータを A/B で直接調整できます。
  • 障害耐性が高い: 壊れても原因が特定しやすく、切り戻しも簡単です。
  • 運用知見が蓄積しやすい: 長年の施策で「どの数字を動かすと何が起きるか」が体感値として溜まっています。

新規プロダクトや、シグナルが十分に溜まっていないフェーズでは、ルールベースは今でも最短ルートだと思います。

見えてきた課題

一方で、ユーザー層と目的の多様性が広がってくると、次のような課題が見えてきました。

  • ユーザー多様性への追従が遅い: 新しい利用目的や層が出てくるたびに、ルールを増やすか既存ルールを改修するしかありません。
  • 個別最適ができない: 全員一律のルールなので、同じ温度感を持つ人同士をピンポイントで繋ぐことができません。
  • トラブルの事後学習ができない: ブロックや通報があっても、ルール側に自動で反映されるわけではなく、改善のたびに人間が仮説を立てて手を動かす必要があります。
  • 初動と継続で導線が分断する: チャンスタイム(新規)とデイリーミッション(継続)の接続が、ロジックとしても体験としても連続しません。
  • ルールの複雑化: これが一番重くなっていく課題です。

ルールの複雑化についてもう少し書くと、

  • 例外が例外を呼ぶ: 「このユーザー群だけ除外」「この時間帯だけ特別扱い」「このアプリバージョン以降はこう」といった分岐が、一度入ると消せずに積もっていきます。
  • ルール同士の相互作用が読めなくなる: 単体では正しいルールが、他のルールと組み合わさることで予期しない動作をします。
  • 変更のリスクが非対称: 新しいルールの追加は安全に見える一方、既存ルールの削除や改修は副作用が読めず怖くなり、結果として削除されないコードが溜まり続けます。

ルールベースは初速こそ速いのですが、メンテコストは時間とともに増えていきます。ある時点からは、新しい施策を入れるより「既存ルールと衝突しないか確認する」ほうが時間を食うようになります。

ユーザーの目的が多様化するほど、全員一律の導線では受け止めきれない領域が広がってきたので、ここを ML 検索で補完することにしました。


2. 温度感を 1 次元スコアとして定義する

まず取り組んだのは、モデルに学習させる前に「温度感とは何か」を自分たちで定義することです。

ユーザーの「出会いに対する姿勢」は、実は 1 本の軸にかなり綺麗に乗ります。

  じっくり  ←─────────────────────────────→  カジュアル
   0.0                                        1.0
  • 左寄り: じっくり話したい、ゆっくり関係を築きたい層
  • 中央: 一般的な出会い目的の層
  • 右寄り: 気軽につながりたい、カジュアル志向の層

さらに、それぞれのユーザーには「自分のスコア位置」だけでなく「どの範囲の相手なら噛み合うか」という希望レンジもあります。ざっくり書くとこういうイメージです。

   じっくり                                            カジュアル
    0.0                                                   1.0
     ├──────────────────────────────────────────────────────┤

       ◆                                                       ← ユーザー A
       ├───────┤  A の希望レンジ

               ◆                                               ← ユーザー B
          ├───────────────┤  B の希望レンジ

                             ◆                                 ← ユーザー C
                        ├──────────────────────────┤  C の希望レンジ

ポイントは、希望レンジがユーザー (カテゴリ) ごとに形が違うという点です。左寄りの層は同じ左寄りの相手を狭めに希望することが多く、中央・右寄りの層は逆に広めのレンジを持ちやすい、といった非対称な分布になります。実際にはこれをもっと細かい複数カテゴリに分けていますが、構造としては同じです。

この軸を決定論的なロジックとして実装しています。

スコア算出のしくみ

  1. フラグ優先判定: 悪質行為フラグや属性フラグなど、確実にカテゴリが決まる条件を最優先で判定します。
  2. 目的ベーススコア: フラグに該当しないユーザーは、プロフィールの「出会いの目的」から平均スコアを算出します。
  3. 希望レンジ: 自分のスコアに対して「どの範囲の相手なら噛み合うか」を希望の中心値として定義します。

この段階ではまだ機械学習は出てきません。プロフィール・属性・目的コードから、決定論的に score と match_center の 2 値を出しているだけです。

ただ、この 2 値が後段の学習モデルの教師情報になります。


3. Two-Tower Model で 64 次元に埋め込む

次に、各ユーザーを 64 次元のベクトル (Embedding) に変換する学習パイプラインを、Amazon SageMaker 上に構築しました。採用したのは、推薦系で定番の Two-Tower Model です。

   [User Tower]                [Target Tower]
        │                            │
        ▼                            ▼
   64 次元ベクトル ──コサイン類似度──▶ マッチングスコア
  • User Tower と Target Tower は同じ構造の別重みです
  • 入力は user_id / sex / score / match_center の 4 カラムのみ
  • 出力は 64 次元の密ベクトルです

なぜ学習させるのか

ここで「score と match_center が決定論的に出るなら、その 2 値でソートすればいいのでは?」と思われるかもしれません。

実は、Embedding の先頭 2 次元はスコアをそのままピン留めしているので、そこだけ見ればロジック単体でも再現できます。ML を使う価値は、むしろ残りの 62 次元のほうにあります。

この 62 次元は実際のユーザー行動 (特にブロック) から学習されるので、

  • 温度感スコアが同じでも、「実際にはブロックされがちな特徴」を持つ人は遠ざけられます
  • プロフィールに明示されていない共通点で近い人同士は、自然と近くなります
  • 過去の行動パターンから、「この相手は希望に合いそうか」という期待度合いを織り込めます

静的な属性ベースのスコアリングに、行動データから学習した「振る舞いの近さ」を重ねる、ということです。先頭 2 次元で説明可能性を担保しつつ、残り 62 次元で汎化を稼ぐ、という役割分担になっています。

損失関数

学習の損失関数は 2 つの項を組み合わせています。

1 つ目は、推薦系で標準的に使われる InfoNCE です。バッチ内のペアを正例・負例としてコントラストさせ、良い組み合わせは近く、悪い組み合わせは遠くなるように学習させます。これに加えて、後述するブロックを明示的な負例として投入しています。

2 つ目は、Embedding の先頭 2 次元を score と match_center に誘導する MSE 項です。解釈可能なスコアがあるので、それを Embedding の先頭次元にそのまま載せてしまおう、という発想です。これによって、

  • 「なぜ近いのか説明できない」マッチングを返しにくくなります
  • 温度感レンジでのフィルタリングを、ベクトル検索側で低コストに再現できます

ブロックを負例として使う

ユーザー間の明示的なブロックは、マッチングでは強い負例シグナルです。学習パイプラインでは、直近 90 日のブロックを weight = -1.0 の負例インタラクションとして投入しています。

ただし、この負例が担っているのは「ブロック当人同士を離す」ことではなく、「ブロック相手に似た別人を遠ざける」ことです。

ブロック関係にある当人同士は、Solr の検索フィルタ側で確定的に除外しているので、設計としては二層になっています。

層 担当 効果
Solr の検索フィルタ 確定フィルタ ブロック当人同士は 100% 出ない
負例 -1.0 ML 学習 ブロック相手に似た別人を Embedding 空間で遠ざける

フィルタで当人は既に落ちているので、ML 側の負例は「似た傾向の他人がまた現れる」事故を確率的に減らす役割に専念できます。片方が外れても最低限の安全性は担保されます。


4. 推論結果の配信(Solr KNN)で配信する

学習した Embedding は Solr の Dense Vector フィールドに投入し、KNN 検索で「自分のベクトルに近いユーザーを k 件返す」形で配信しています。

既存の属性フィルタ (性別・年齢・エリア・ブロック除外など) は Graph Pre-Filter として併用できるので、ベクトル検索と条件検索のハイブリッドになります。


5. 何が変わるのか

今回追加した温度感ベクトル KNN 検索と、これまでのルールベース検索との違いは次のとおりです。

観点 これまで (ルールベース) 追加した ML 検索 (温度感ベクトル KNN)
推薦の基準 新規ユーザー優先・最終ログイン順などの並び替え ユーザー同士の温度感の近さ
新規目的への対応 ルール追加や改修 プロフィール更新 → 次回学習で反映
トラブル抑止 人手でルールを足す ブロック負例でモデルが学習
説明可能性 ルールを辿れば説明可 先頭 2 次元にスコアを固定して担保
検索性能 属性 INDEX 頼り Solr KNN で高速ハイブリッド検索

6. 直近のネクスト: 数字を見ながら ML 側に寄せていく

ここまでで「決定論的スコア + Embedding ベースの類似検索」という土台はできましたが、現時点では既存のルールベース導線と ML 検索を併用しながら効果を計測している段階です。マッチング検索全体を ML 側に寄せるかどうかは、数字を見ながら判断していくことになります。

直近のネクストは、

  1. マッチ成立率、メッセージ継続率といったプロダクト側の KPI で ML 検索の効果を計測する
  2. 結果を見ながら、学習データ・特徴量・損失設計を改善していく
  3. 数字が安定して良くなったところで、ML 検索の比率を上げていき、最終的にはマッチング検索をルールベース側から ML 側に寄せていく

という流れを想定しています。ML モデルは学習データや特徴量を入れ替えれば継続的に改善できるので、しばらくはルールベースと併用しながら、数字を見て少しずつ振り方を ML に寄せていく構成で考えています。

その先の改善余地としては、以下のような項目も見えています。

  • シグナル設計の余地: 現状はブロックを負例として使っているのみで、ポジティブな行動 (メッセージ継続、マッチング成立など) をどう反映させるか?
  • コールドスタート: 行動ログがない新規ユーザーに向けてどう最適化するか?
  • 再学習サイクル: 現状は日次バッチですが、更新頻度と計算コストのバランスをどう取るか?

まとめ

今回は、出会いの「温度感」を マッチング検索に乗せるために、Two-Tower Model と Solr KNN でやったことを書きました。

  • 温度感を決定論的なスコアとして定義した上で、それを教師情報として Two-Tower Model を学習させ、Solr KNN で配信する構成にしました
  • Embedding の先頭 2 次元にスコアをピン留めすることで、説明可能性を保ちつつ、残り 62 次元で行動データからの学習を効かせています
  • ブロックは確定フィルタ (Solr) と ML 負例の二層で効かせる設計にしました
  • ML 検索の効果はまだ計測中で、既存のルールベース導線と併用しながらチューニングを続けていく予定です

aws.amazon.com